ChatGPT 구독으로 GPT-6 Astra·GPT-6.1 Sol을 쓰는 사람은 별도 설정 없이 기본 응답 속도 개선을 받는다는 발표입니다. 약 50% 향상은 OpenAI의 주장입니다. 뒤이어 확인한 Devin 구독 연결 조건도 이 글에 덧붙였습니다.
28일 동안 이어지는 발표 가운데 이 일차에 해당하는 기록입니다. 다른 일차는 시리즈 전체 목차에서 이어 읽을 수 있습니다.
한눈에 보기
| 궁금한 점 | 이번 발표의 핵심 |
|---|---|
| 무엇이 바뀝니까? | Astra·Sol 기본 속도 약 50% 향상 발표입니다. |
| 제공 경로는? | ChatGPT 구독과 Sign in with ChatGPT를 지원하는 도구입니다. |
| 설정·비용은? | 속도 개선은 변경 불필요입니다. Devin Token Sharing은 별도 연결과 유료 Devin 플랜이 필요합니다. |
| 한국 적용은? | 한국 계정의 반영 시각과 한국어 개선 폭은 미확인입니다. |
약 50% 빨라졌다는 말은 어디까지 확인됐습니까?
발표의 표현은 두 모델의 “default speed”가 약 50% 빨라졌다는 것입니다. 기본 속도라는 용어만으로 첫 응답까지의 시간, 초당 출력 토큰, 전체 작업 완료 시간 가운데 어느 지표를 측정했는지는 미확인입니다. 입력 길이·추론 강도·서버 혼잡도별 측정표도 미공개입니다. 이 수치는 두 모델에 대한 서비스 개선 주장으로 읽을 수 있으며, 독립적인 성능 비교에는 별도의 측정 자료가 필요합니다. (발표 문구)
속도와 완료 시간의 차이는 단위를 바꿔 보면 드러납니다. 같은 양을 처리하는 속도가 1.5배가 됐다고 가정하면 시간은 이전의 약 3분의 2, 즉 약 33% 줄어드는 계산입니다. 이는 표현을 이해하기 위한 계산 예시입니다. 코딩 에이전트 작업에는 모델 응답 외에 파일 읽기, 테스트 실행, 도구 호출과 재수정 시간도 들어갑니다. 그 단계가 얼마나 걸리는지에 따라 전체 체감은 달라집니다.
같은 저장소·같은 지시·같은 모델과 추론 설정으로 작업을 반복하고, 답변 대기 시간과 테스트까지 끝난 시간을 따로 기록하면 자신의 작업에 얼마나 도움이 되는지 판단하기 쉽습니다. 정답 여부와 테스트 통과도 함께 보면 빠른 응답이 결과물 완성으로 이어지는지 구분할 수 있습니다. 기본 속도 개선과 별개로 기존 모델의 품질 비교는 GPT-6.1 Sol 안내와 GPT-6 Astra 안내에서 따로 볼 수 있습니다. (이번 발표의 범위)
한국에서는 어떤 이용 조건으로 적용됩니까?
핵심 조건은 위치보다 ChatGPT 구독을 통해 두 모델을 사용하는 경로입니다. Sign in with ChatGPT는 도구에 ChatGPT 계정으로 로그인하는 방식입니다. 발표는 이를 지원하는 OpenAI 제품과 제휴 도구를 대상으로 들며 OpenCode, Pi, Amp, Devin을 예시로 적었습니다. 이 목록은 각 제휴 도구의 모든 모델·모든 인증 방식이 같은 개선을 받는다는 뜻으로 확대하기보다, 구독 로그인으로 Astra나 Sol을 쓰는 경우에 대응시킬 수 있습니다. (적용 대상 발표)
공식 도움말은 원하는 Codex 클라이언트를 실행하고 안내에 따라 ChatGPT 계정으로 로그인하는 이용 방법을 설명합니다. 한국 독자는 자신이 해당 계정으로 구독을 이용하는지와 두 모델에 접근할 수 있는지를 먼저 확인하면 적용 경로를 구분할 수 있습니다. 계정·워크스페이스의 기존 모델 접근 조건은 따로 살펴볼 사항입니다. 한국 계정에서 언제 적용됐는지와 한국어 작업의 개선 폭은 아직 미확인입니다. (한국어 Codex 도움말)
반면 API 키로 요청하는 서비스는 구독 로그인과 다른 경로입니다. Day 1 발표에서 API 전체 적용은 확인되지 않았습니다. 기존 API의 모델 ID·요금이나 속도 옵션을 바꿔야 한다는 안내도 이번 항목에서 찾지 못했습니다. 구독 도구에서의 개선을 자체 API 애플리케이션의 성능·가격 변화로 옮겨 계산하기보다는 실제 호출 경로를 기준으로 판단할 수 있습니다. (발표 대상의 근거)
설정과 비용은 어떻게 달라집니까?
Day 1은 사용자가 설정을 바꾸지 않아도 적용된다고 안내한 개선입니다. 원 게시물에는 이후 약 2시간 안에 체감할 수 있다는 설명이 붙었습니다. 한국 시각의 배포 완료 시각은 원 게시물의 시간대와 함께 미확인으로 남습니다. 이 두 시간은 발표 당시의 반영 예상이며, 한국 계정의 실제 반영 시각은 미공개입니다. (설정·적용 안내)
비용은 발표상 별도 설정·결제 없이 기존 구독 이용 경로에 적용되는 개선으로 정리할 수 있습니다. 새 속도 옵션 구입이나 API 가격 변경은 미확인입니다. 기존 구독료와 각 제휴 도구의 자체 요금·이용 한도는 별개입니다. 이번 표의 비용 칸은 Day 1 개선의 적용 방식이며, 서비스 이용 비용은 기존 요금 조건을 따릅니다. 공식 도움말도 Codex 사용 한도가 요금제에 따라 다르다고 설명합니다. (Day 1 안내 · 구독 사용 조건)
10월 10일 후속: Devin에 ChatGPT 구독을 어떻게 연결합니까?
Day 1에 파트너로 언급됐던 Devin의 구독 연결 조건이 구체화됐습니다. Cognition 게시물은 10월 9일 22:52:07 UTC(한국 시각 10월 10일 07:52:07), 이를 소개한 Tibo 게시물은 10월 10일 04:33:40 UTC(한국 시각 13:33:40)에 올라왔습니다. 확인한 캠페인 기록에는 Day 6 또는 새 리셋 발표가 없어 별도 후속으로 다룹니다. (Cognition 발표 · Tibo 후속 · 캠페인 기록)
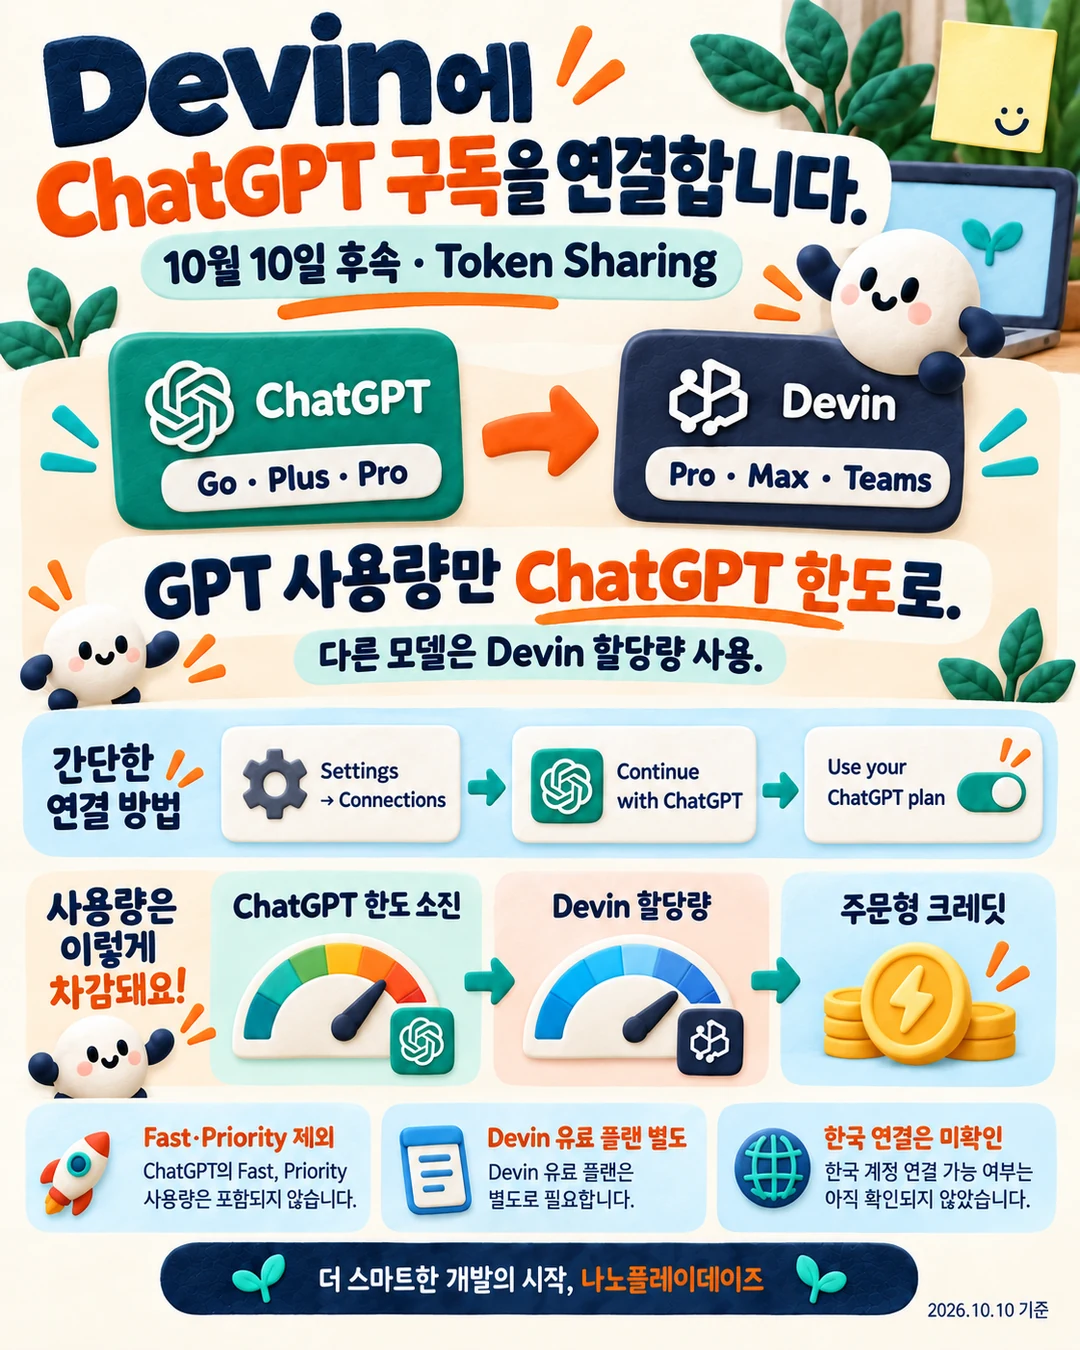
Devin의 Token Sharing은 세션에서 GPT 모델을 쓰는 부분을 ChatGPT Go·Plus·Pro의 사용량으로 청구하는 기능입니다. Settings > Connections에서 Continue with ChatGPT를 선택해 계정을 연결하고 Use your ChatGPT plan을 켭니다. 같은 설정에서 끄거나 연결을 해제할 수 있습니다. 연결과 스위치 하나가 Devin Cloud·Desktop·CLI 전체에 적용됩니다. 사용량은 Settings > Usage & limits의 Manage usage로 ChatGPT에서 확인합니다. (설정 도움말)
적용 대상은 Devin에서 제공하는 GPT 모델이며 Fast·Priority 변형은 제외됩니다. Fusion은 여러 모델을 함께 쓰는 모드로, 선택한 GPT 모델 부분만 ChatGPT 사용량으로 청구되고 나머지는 Devin 할당량을 씁니다. Adaptive는 모델을 자동 선택하므로 GPT로 라우팅된 부분에만 적용됩니다. Teams에서는 각 이용자가 자기 ChatGPT 구독을 연결하며 자기 소유 세션에 적용됩니다. 한국에서 이 연결 기능을 쓸 수 있는지는 미확인입니다. (모델·모드·계정 조건)
Devin 연동의 이용 조건과 비용·요금은 무엇입니까?
ChatGPT 구독과 별도로 Devin Pro·Max·Teams 플랜이 필요합니다. Devin Free·Enterprise는 Token Sharing 지원 대상에서 제외됩니다. 2026년 10월 10일 가격표의 미국 달러 표시액은 다음과 같습니다. (지원 플랜 · Devin 가격표)
| Devin 플랜 | 월 표시 요금 | ChatGPT 연결 |
|---|---|---|
| Pro | $20 | 지원 |
| Max | $200 | 지원 |
| Teams | 기본 $80 + 정식 좌석당 $40 | 이용자별 연결 |
| Free·Enterprise | 무료·별도 상담 | 미지원 |
ChatGPT에 청구되는 GPT 부분은 Devin 할당량이나 주문형 크레딧에서 중복 차감되지 않습니다. 다른 모델은 계속 Devin 할당량을 사용합니다. ChatGPT 한도가 소진되거나 연결 계정을 이용할 수 없으면 세션은 계속 실행되며 GPT 부분도 Devin 할당량으로 청구되고, 그 할당량까지 소진되면 주문형 크레딧으로 넘어갑니다. ChatGPT 한도가 리셋되면 GPT 사용량은 다시 ChatGPT에 청구됩니다. 연결 후에도 Devin 자체 요금과 추가 사용량 경로를 함께 확인할 수 있습니다. (소진 후 청구 도움말)
반응 (2026년 10월 10일 확인 기준)
Reddit r/codex에서는 속도 개선을 보고한 개인 측정 사례가 나왔습니다. OpenAI 개발자 커뮤니티에서는 개선 방식과 실제 체감을 놓고 의견이 이어졌습니다. Hacker News·GeekNews의 관련 토론과 한국어 사용 후기는 찾지 못했습니다. 아래는 모두 개인 경험·의견이며, OpenAI의 약 50% 향상을 독립적으로 검증한 결과로 읽지 않습니다.
- Day 1 토론의 엇갈린 체감. r/codex Day 1 토론의 한 사용자는 Pi/OMP에서 간단한 시를 생성할 때 초당 13.5~20.5토큰을 기록했다고 적었습니다. 발표 후 약 2시간이 지난 뒤와 다음 날에도 약 20토큰/초였다고 합니다. 다른 일부 사용자는 더 빨라졌다고 했고, 개선 전 속도로 돌아온 것 아니냐는 반응도 있었습니다. 같은 토론 안에서도 체감이 갈렸고, 향상 폭을 따지려면 같은 조건의 전후 비교가 필요합니다. (Day 1 사용자 반응)
- 속도 향상이 사용량 소모를 늘릴까 하는 걱정. 같은 스레드의 일부 의견은 빨라진 만큼 사용량이 더 빨리 닳을지를 걱정했습니다. 이는 사용자의 걱정이고, 사용량 차감 방식이 바뀐다는 발표는 아직 없습니다. 출력 속도는 응답이 나오는 빠르기이고, 요금제 사용량은 작업에 적용되는 한도입니다. Day 2.1의 안전 검사 차감 면제도 Day 1 속도 개선과는 별도 조건입니다. (Day 1 사용량 관련 의견)
- TPS는 개선됐지만 발표 수치에는 못 미쳤다는 사례. r/codex의 Bartolomeus42는 자신의 초당 토큰 수(TPS)가 개선됐지만 Tibo가 말한 약 50%에는 못 미쳤다고 적었습니다. 발표 전 일부 데이터는 “Selected model is at capacity” 메시지 때문에 빠졌다고 밝혔습니다. 모델의 처리 용량 문제로 측정이 누락된 개인 기록이라 독립적인 개선율 검증으로 일반화하기에는 조건이 제한됩니다. (r/codex 개인 측정 글)
참고한 자료
자료 확인일은 2026년 10월 10일입니다. 한국 계정의 실제 적용은 직접 시험하지 않았습니다.