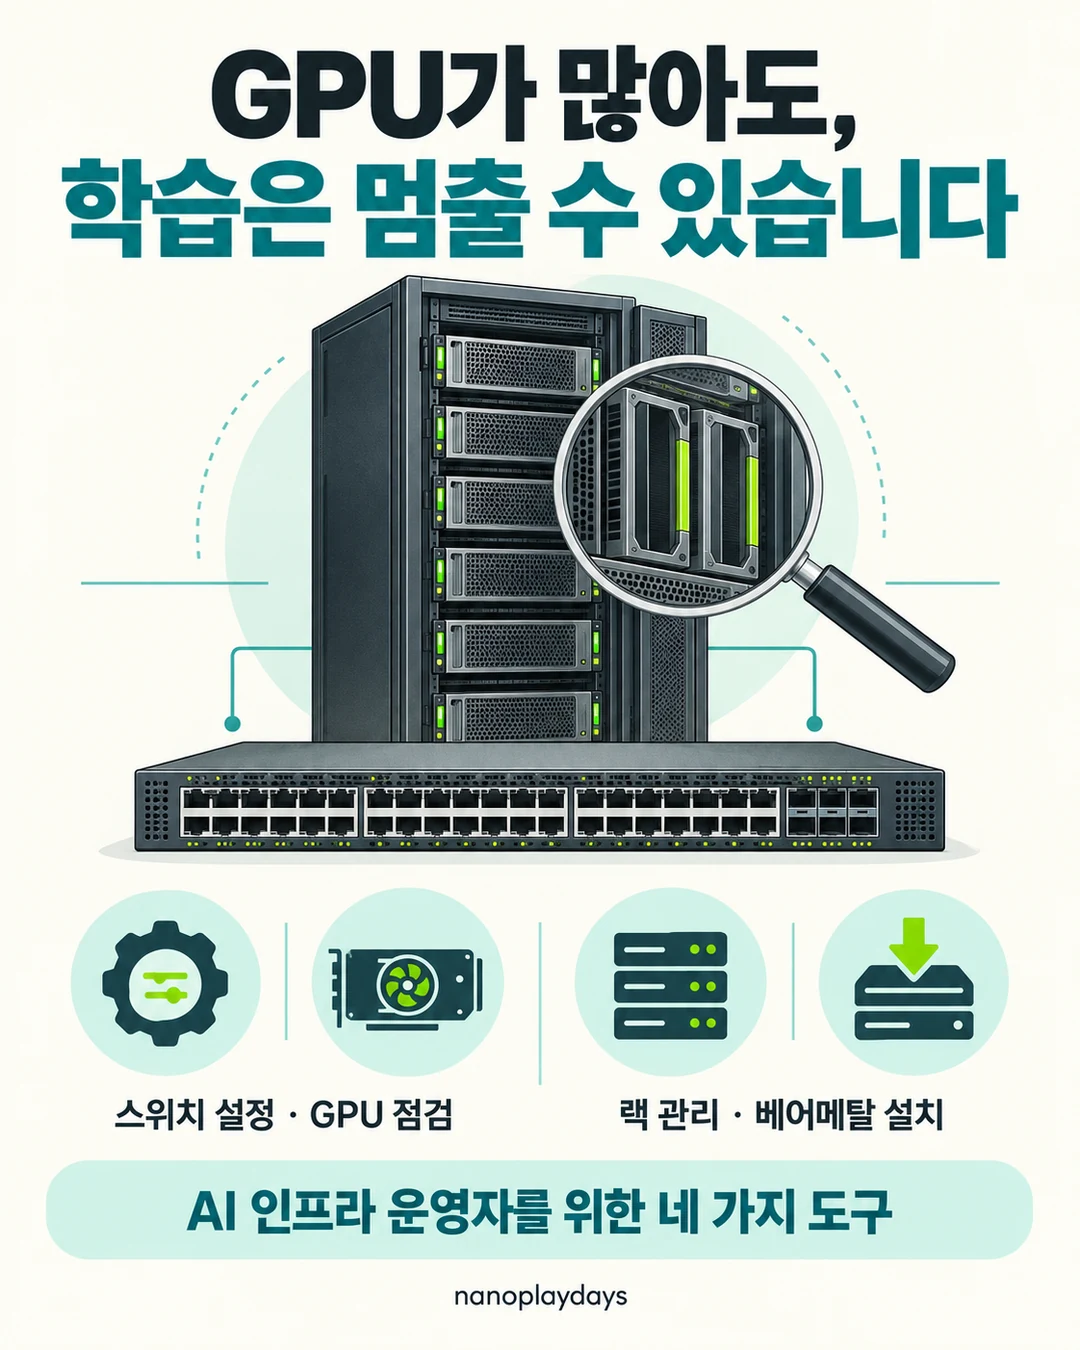
GPU를 많이 연결해도 스위치 설정이 어긋나거나 장비 하나에 문제가 생기면 AI 학습이 멈출 수 있습니다. NVIDIA는 10월 12일 OCP Global Summit에서 DSX AI Factory의 운영 도구 네 가지를 공개했습니다. 네트워크 설정부터 학습 전 점검, 랙 관리, 물리 서버 준비까지 데이터센터 운영자가 자동화할 수 있는 영역을 넓혔습니다. 2026년 10월 13일 기준, GPU 인프라를 구축하는 팀이 살펴볼 핵심은 각 도구의 역할과 설치 전제입니다. 공식 발표
AI 팩토리에는 무엇을 운영하는 도구가 필요합니까?
AI 팩토리는 AI 학습·추론을 대규모로 수행하는 데이터센터를 가리킵니다. OCP(Open Compute Project)는 이런 인프라의 설계와 규격을 공개하고 공유하는 프로젝트입니다. NVIDIA의 DSX는 컴퓨팅·네트워크·전력·냉각·시설과 소프트웨어를 함께 설계하고 운영하는 플랫폼이며, DSX OS는 그중 운영 소프트웨어를 묶는 계층입니다. 공식 발표 · DSX 구성 안내
DSX의 설계·시뮬레이션 기반은 앞서 공개됐습니다. NVIDIA는 2025년 10월 Omniverse DSX Blueprint를 소개하며 실제 시설을 짓기 전 디지털 트윈에서 건물·전력·냉각과 컴퓨팅을 함께 검토하는 방법을 설명했습니다. 디지털 트윈은 실제 시설을 가상 공간에 모델링해 동작을 살펴보는 방식입니다. 이번 OCP 발표에서는 그 인프라의 실제 운영을 맡는 소프트웨어 구성요소를 확장했습니다. 2025년 DSX Blueprint 발표 · 이번 운영 도구 발표
| 공개 도구 | 맡는 운영 대상 | 살펴볼 상황 |
|---|---|---|
| Config Manager | 네트워크 스위치 설정 | 많은 스위치에 일관된 설정을 배포·검증·유지할 때 |
| Cluster Readiness Engine(NVCRE) | 여러 GPU 서버를 묶은 클러스터 | 학습을 시작하기 전 부하 시험과 하드웨어 이상 점검을 할 때 |
| Rack Management Service(RMS) | 서버·전원·스위치를 담은 랙 | 장비 목록, 전원 제어, 펌웨어 갱신을 랙 단위로 관리할 때 |
| Cluster API Provider for NVIDIA Infrastructure Controller | 베어메탈 서버 준비 | 물리 서버를 Kubernetes 클러스터용 머신으로 제공할 때 |
이 도구들은 클라우드 제공자와 소프트웨어 파트너가 여러 고객의 인프라를 운영하는 플랫폼에 통합하도록 공개됐습니다. 발표자는 NVIDIA이며, 장애 감소나 설치 시간 단축의 실제 효과는 각 운영 환경에서 확인해야 합니다. 공식 발표
스위치 설정: Config Manager는 개발자 프리뷰입니다
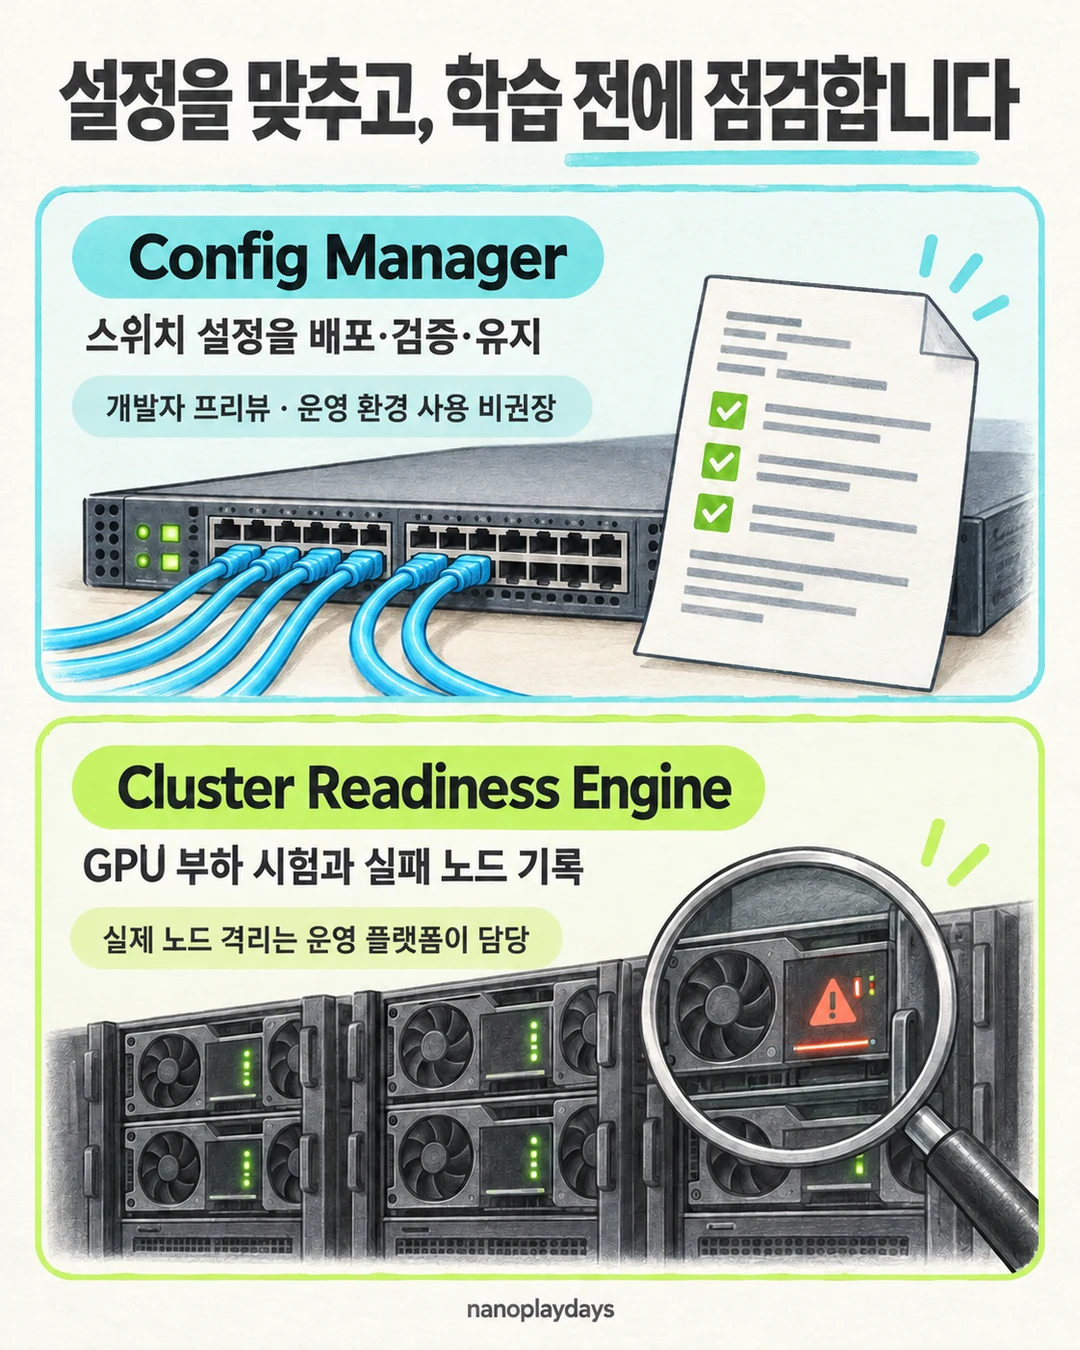
스위치는 서버 사이의 데이터가 오가는 경로를 연결합니다. Config Manager는 장비 관리 데이터와 템플릿을 바탕으로 설정을 생성하고, 초기 설치와 변경 작업을 자동화합니다. 설정 저장소와 작업 흐름을 단일 Helm 배포로 묶으며, Helm은 Kubernetes 애플리케이션을 설치·관리하는 도구입니다. 저장소에는 설치기의 대화형 화면과 CLI가 안내돼 있습니다. 현재 Developer Preview 상태이며 README는 운영 환경 사용을 권하지 않습니다. 먼저 시험 환경에서 자신의 장비와 설정 흐름을 확인할 도구입니다. Config Manager README·설치기
학습 전 점검: Cluster Readiness Engine은 결과를 남깁니다
NVCRE는 GPU 클러스터에 시험 작업을 실행하고 하드웨어 이상과 처리량을 점검하는 Kubernetes 컨트롤러입니다. 여러 서버를 장시간 부하에 노출하는 번인 시험, 벤치마크, 실패 노드의 원인 기록을 돕습니다. 실패한 노드를 기록한 뒤 실제 격리를 수행하는 일은 운영 플랫폼이 맡습니다. 학습 시작 전에 점검 결과를 확인하고 문제가 있는 노드를 처리하는 흐름에 연결할 수 있습니다. NVCRE README
랙 관리와 물리 서버 준비는 서로 다른 작업입니다
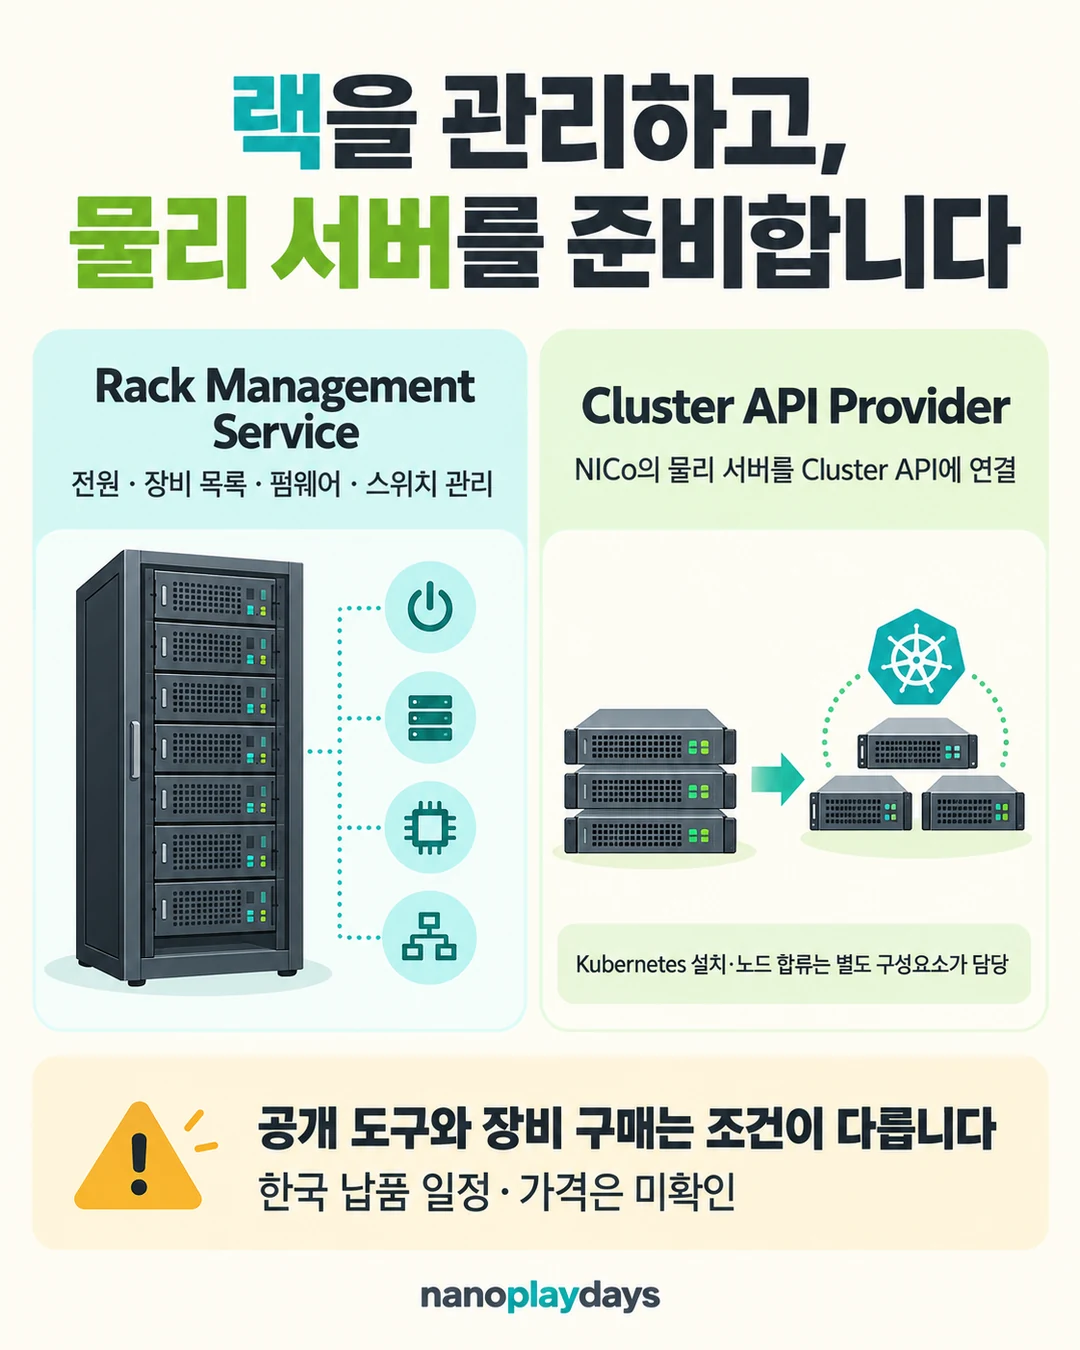
RMS는 랙의 전원 제어, 장비 목록 조회, 펌웨어 갱신, 스위치 설정을 하나의 gRPC API로 제공합니다. gRPC는 서비스끼리 정해진 형식으로 작업을 요청하는 통신 방식입니다. 오래 걸리는 갱신 작업은 비동기 작업으로 실행하고, 호출한 서비스가 완료 상태를 조회합니다. 저장소에서 소스 빌드와 Kubernetes 배포 안내, 지원 하드웨어 목록으로 들어갈 수 있습니다. RMS README
베어메탈은 가상머신 대신 물리 서버를 직접 사용하는 환경입니다. Cluster API Provider인 CAPNICo는 Kubernetes Cluster API가 요청한 머신을 NVIDIA Infra Controller(NICo)의 실제 하드웨어 인스턴스로 마련합니다. Kubernetes 설치와 노드 합류는 kubeadm bootstrap·control-plane provider가 맡습니다. README는 이 프로젝트를 **실험 단계(experimental)**로 표시합니다. 이미 Cluster API로 클러스터를 관리하는 팀은 같은 선언 방식에 NICo 서버를 연결하는 경로를 검토할 수 있습니다. CAPNICo README와 시작 안내
NVIDIA는 발표에서 물리 서버를 운영 가능한 클러스터로 만드는 시간을 일 단위에서 시간 단위로 줄인다고 설명했습니다. 이 표현에는 구체적인 장비 구성과 동일 조건의 비교 시험이 제시되지 않았습니다. 공식 발표
제공·이용 조건: 문서와 저장소에서 시작합니다
공개된 구성요소의 입구는 DSX 문서와 DSX AI Factory GitHub입니다. 네 도구의 설치 경로는 서로 다릅니다. Config Manager는 Installer, RMS는 빌드·배포 문서, CAPNICo는 NICo 측 준비 사항과 인증·OS 이미지 조건을 설명하는 Getting Started에서 시작합니다. 기존 Kubernetes 환경과 장비 관리 권한을 가진 운영자를 대상으로 합니다. Config Manager · RMS · CAPNICo
NVCRE 문서의 최신 표시는 v0.6.0입니다. CLI를 설치한 뒤 nvcrectl setup init으로 컨트롤러와 Kubeflow Trainer 의존성을 준비하거나, Helm 차트를 직접 설치할 수 있습니다. Helm 경로에서는 Trainer를 따로 설치합니다. 공개 이미지와 차트는 GitHub Container Registry(GHCR)에서 받아 토큰 없이 설치할 수 있습니다. 설치 상태는 nvcrectl setup status로 조회합니다. 배포 문서
GPU Operator가 필요하고, 기본 메트릭 설정에는 Prometheus Operator의 리소스 정의가 필요합니다. GB200·GB300 시험 항목에는 NVIDIA DRA 드라이버가 추가로 필요합니다. 외부 레지스트리 접근이 제한된 환경은 차트와 컨트롤러·시험 작업 이미지를 내부 레지스트리에 미러링하는 절차를 확인해야 합니다. 실제 시험은 GPU 자원을 사용하므로 기존 작업과 분리할 시험 시간·자원도 정해야 합니다. NVCRE 준비 조건 · 제한된 네트워크의 배포 경로
한국에서 검토할 때는 공개 코드의 접근 경로, 보유 장비의 호환성, 장비 구매를 각각 확인하면 됩니다. 이번 발표에는 한국 납품 일정과 지역별 지원 계약이 제시되지 않았습니다. 또한 DSX 문서의 일부 Reference Design은 NVOnline 접근 권한이 필요하며 NVIDIA 담당자에게 문의하도록 안내합니다. 공개 소프트웨어 저장소와 설계 자료의 접근 조건이 다릅니다. 공식 발표 · DSX 설계 자료 안내
공개 표준은 전력·냉각·랙 설계까지 다룹니다
같은 발표에서는 NVIDIA·AMD·Google·Meta가 참여한 Open Data Center Specification v0.7도 소개됐습니다. 전력 구조, 냉각 시설, 물리적 배치를 다루는 공통 설계 규격입니다. Google·Meta·Microsoft·NVIDIA의 OCP Grid Resilience Specification은 전력망에 문제가 생겼을 때 연결을 유지하고 자동 대응하며, 2초 미만에 거의 전체 부하로 복귀하는 동작을 규정합니다. 여기서 2초는 규격이 제시하는 요건으로, 한국 데이터센터에서 측정한 복구 기록과 구분됩니다. 공식 발표
NVIDIA는 Vera Rubin의 랙·컴퓨트 트레이 설계도 MGX 아키텍처를 통해 OCP에 기여했습니다. MGX 1.2는 랙 단위 액체 냉각과 연결 구조, 액체 냉각형 5,000A 버스바, 최대 250kW 랙 배치를 지원하는 설계를 설명합니다. 버스바는 큰 전류를 전달하는 전력 도체입니다. 공개 규격은 제조사들이 호환되는 장비를 설계할 공통 기준을 제공합니다. 공식 발표
파트너 발표도 이어졌습니다. Visionbay의 K-1은 Vera Rubin 시대를 위한 800V 직류 AI 팩토리 계획이며, Meta는 Spectrum-6 기반 네트워크 채택을 발표했습니다. NVIDIA·Cisco의 USFP는 고밀도 광통신 모듈 규격, Google의 Falcon Transport 지원은 향후 ConnectX-10 SuperNIC·BlueField DPU를 대상으로 합니다. 소프트웨어 공개, 규격 기여, 장비 채택과 미래 지원 계획은 각각 도입 시점이 다릅니다. 공식 발표
비용·요금: 코드 라이선스와 인프라 비용을 따로 봅니다
Config Manager, NVCRE, RMS, CAPNICo 저장소는 Apache-2.0 라이선스를 표시합니다. 사용·변경·배포 시 각 저장소의 LICENSE·NOTICE와 함께 쓰는 의존성의 조건을 확인하면 됩니다. 공개 코드를 받아 설치하더라도 GPU 서버, 네트워크, 전력, 시험 자원과 운영 인력에는 비용이 듭니다. Config Manager · NVCRE · RMS · CAPNICo
이번 발표에서 네 도구를 묶은 유료 서비스 요금, 파트너 장비의 한국 구매 가격, 한국 원화 견적은 확인되지 않았습니다. 운영 팀은 자동화하려는 작업을 먼저 고르고, 필요한 장비·자원·지원 범위의 견적을 따로 확인할 수 있습니다. 공식 발표
반응 (2026년 10월 13일 기준)
공개된 사용자 반응은 아직 확인되지 않았습니다.
함께 읽기
추론 인프라의 칩·메모리·랙 구성이 궁금하다면 Microsoft Maia 300의 2027년 배포 계획과 비교 조건을 함께 읽을 수 있습니다. DSX 소식은 그처럼 큰 시스템을 준비하고 운영하는 도구와 공통 규격을 살펴보는 데 도움이 됩니다.
참고한 자료
확인일: 2026년 10월 13일. 기능·효과·장비 계획의 발표자는 NVIDIA와 해당 파트너입니다.