AI가 긴 문서를 읽고, 답변을 이어 쓰고, 여러 도구를 오가며 일할 때 서버에는 무엇이 더 필요할까요? Microsoft는 10월 12일 Maia 300 추론 시스템을 발표했습니다. 학습한 AI 모델이 답변을 만드는 과정을 추론이라고 합니다. Maia 300은 이 작업을 대규모로 처리할 인프라로, 2027년 생산 배포를 시작할 예정입니다. 2026년 10월 13일 기준으로 독자가 살펴볼 핵심은 메모리·연결 구조의 변화와 서비스 이용 조건의 공개 상태입니다. 공식 발표
칩 하나보다 답변을 만드는 시스템 전체를 바꿉니다
Maia는 Microsoft가 자체 설계하는 AI 가속기 계열입니다. 가속기는 AI 계산을 맡는 전용 칩입니다. Maia 300에서는 칩뿐 아니라 소프트웨어, 메모리, 가속기 사이의 네트워크, 서버를 모은 랙, 전력·냉각 설계를 함께 맞췄습니다. Microsoft가 내세우는 작업은 긴 문맥을 활용하는 추론, 응답 지연이 중요한 대화, 여러 단계를 지속해서 수행하는 에이전트 작업입니다. 공식 발표
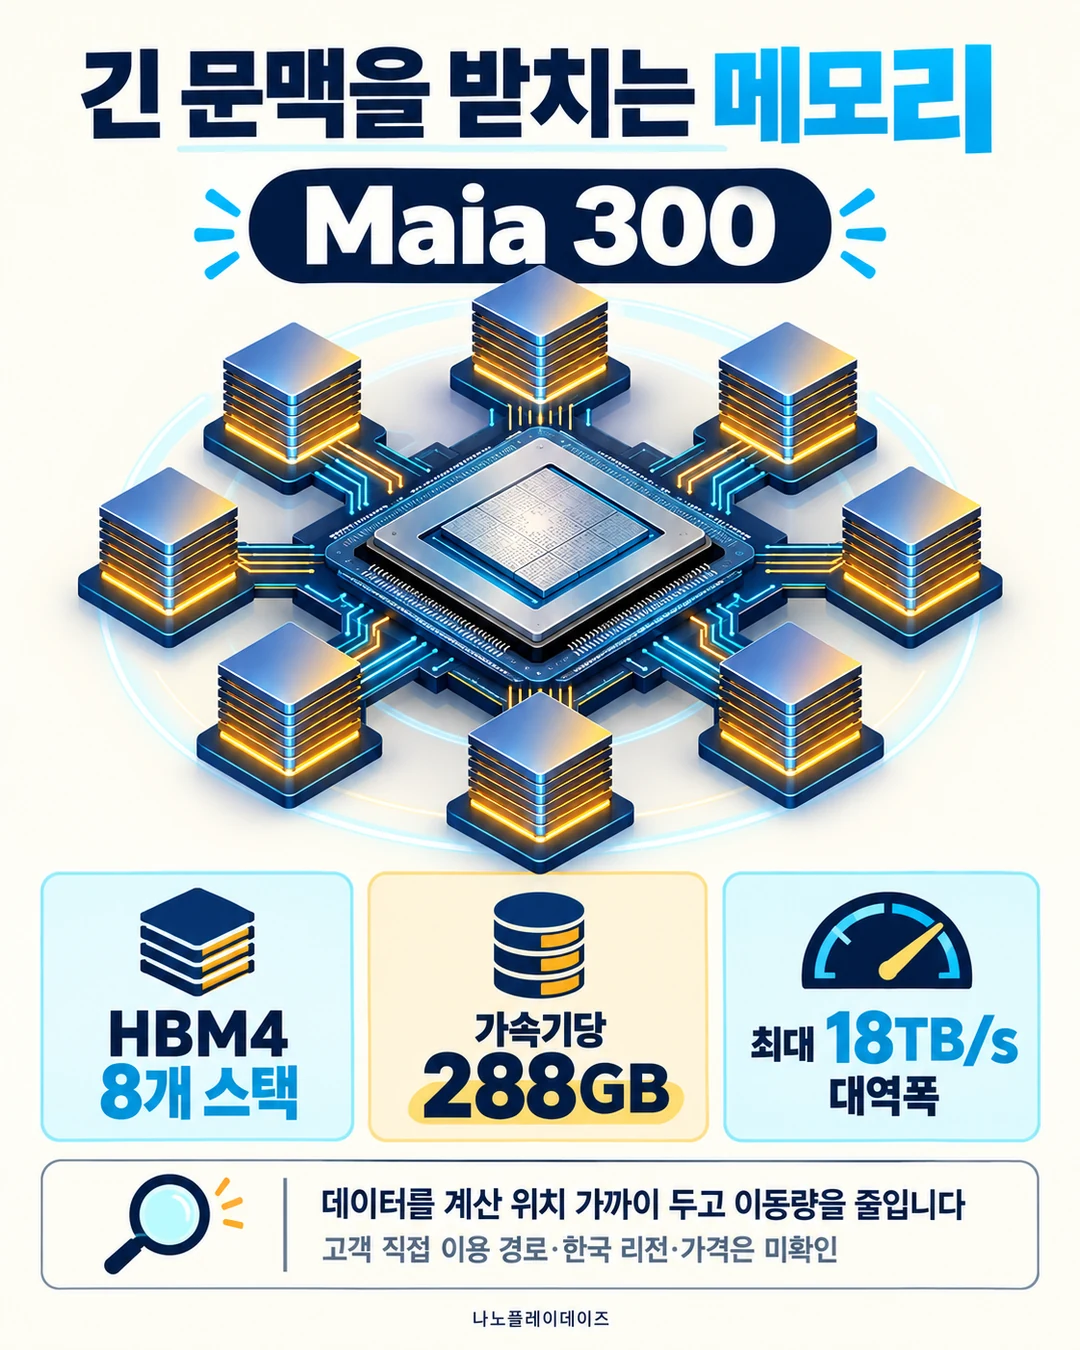
왜 메모리를 강조할까요? 모델이 답변을 이어 만들려면 계산 장치에 필요한 데이터를 계속 공급해야 합니다. 문맥이 길어지면 앞서 읽은 내용의 계산 상태를 보관하는 KV 캐시도 커집니다. Microsoft의 설계는 데이터를 계산 위치 가까이에 놓고, 이동하는 데이터의 양을 줄이는 데 초점을 맞췄습니다. 이를 위해 연산·메모리 제어·입출력 기능을 여러 칩 조각인 칩렛으로 나누고, 연산 칩렛에는 TSMC N2P 공정을 사용합니다. 아키텍처 설명
Maia 200에서 달라진 메모리와 연결 구조
HBM은 AI 가속기 옆에 쌓아 올리는 고대역폭 메모리입니다. 용량은 데이터를 얼마나 담을지, 대역폭은 데이터를 얼마나 빠르게 옮길지를 나타냅니다. 다음 수치는 Microsoft가 공개한 설계 사양입니다. Maia 200 발표 · Maia 300 아키텍처
| 항목 | Maia 200 | Maia 300 |
|---|---|---|
| 가속기당 HBM | HBM3e, 216GB | HBM4 8개 스택, 288GB |
| 가속기당 메모리 대역폭 | 7TB/s | 최대 18TB/s |
| 칩 TDP | 750W | 950W |
| 랙당 가속기 수 | 48개 | 96개 |
| 함께 연결하는 최대 가속기 수 | 6,144개 | 12,288개 |
TDP는 칩의 열·전력 설계 기준입니다. Maia 300의 950W와 96개 가속기를 담은 랙 전체의 167kW는 각각 다른 범위를 나타냅니다. 랙에는 호스트 프로세서·메모리·스토리지·네트워크·냉각 장치도 들어갑니다. Microsoft는 이 구성에서 HBM 용량 27.6TB와 합산 대역폭 1.7PB/s를 제시했습니다. 공식 발표 · 아키텍처 설명
메모리 설계에는 향상된 MXFP4와 3비트 미만 저장 형식도 포함됩니다. 데이터를 더 좁은 표현으로 담아 모델과 KV 캐시가 차지하는 공간과 전송량을 줄이는 접근입니다. 네트워크는 Ethernet 기반의 전용 AI 전송 방식을 사용해 최대 128개 랙을 하나의 슈퍼팟으로 연결합니다. 긴 입력을 먼저 처리하는 prefill 작업과 답변 토큰을 이어 만드는 decode 작업을 서로 다른 가속기에 배치하고, 필요한 KV 상태를 같은 연결망으로 옮길 수 있게 설계했습니다. 아키텍처 설명
‘최대 7배’와 ‘40% 증가’는 무엇을 비교합니까?
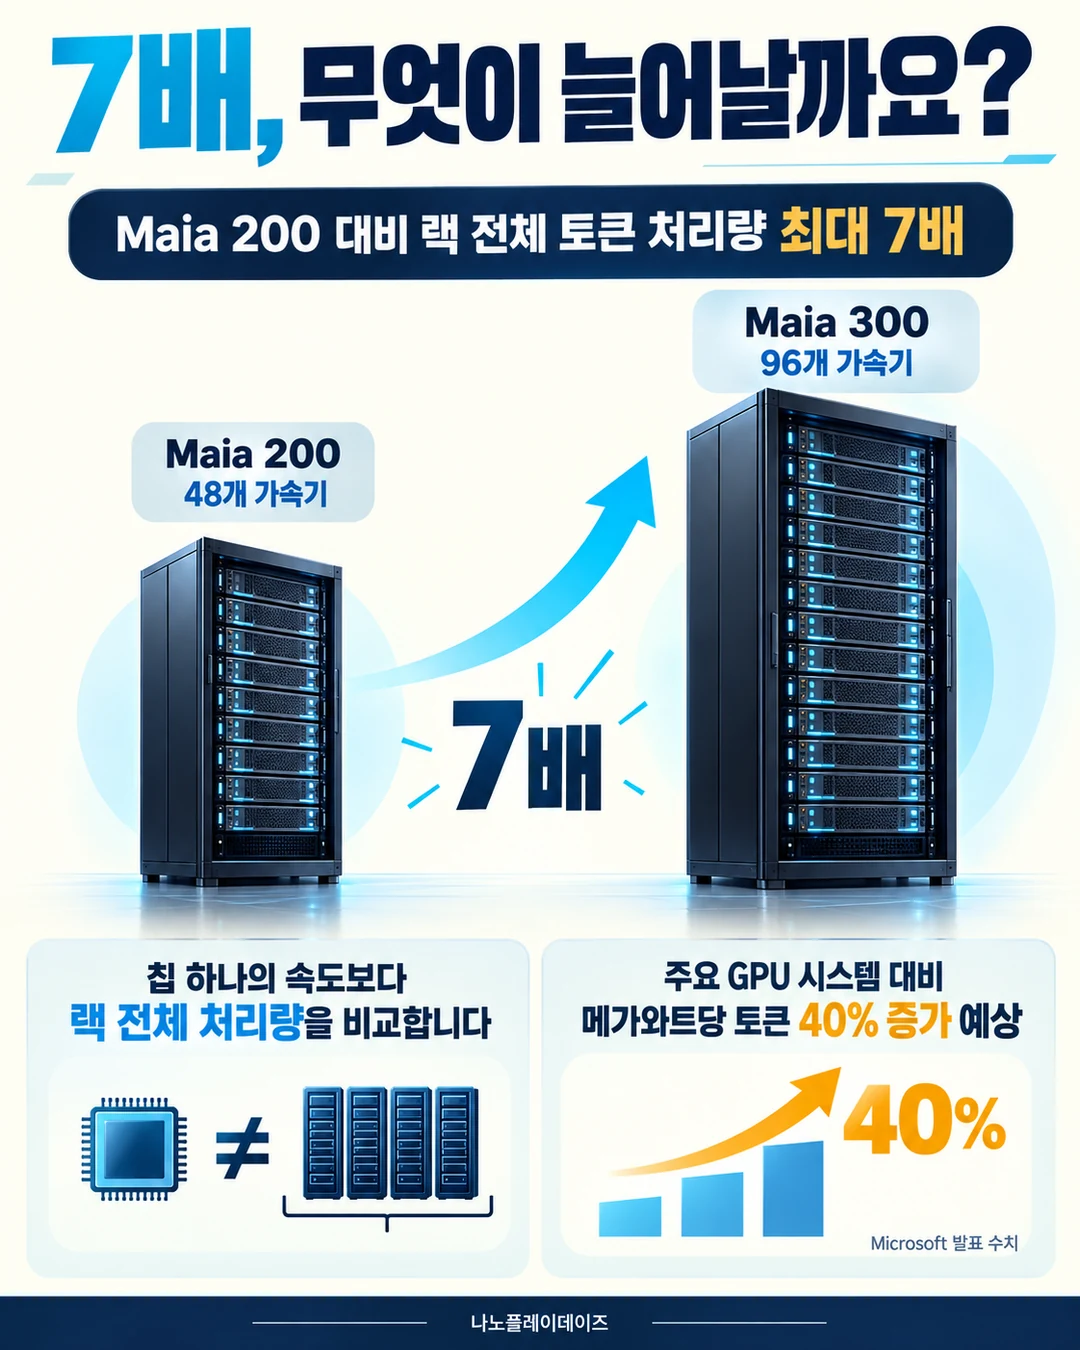
두 숫자는 비교 대상과 단위가 다릅니다. 토큰은 AI가 입력과 출력을 처리할 때 나누는 텍스트 단위입니다. 처리량은 일정 시간에 얼마나 많은 토큰을 처리하는지 나타냅니다. Microsoft가 발표한 수치는 다음과 같습니다. 공식 발표
| 발표 수치 | 비교 대상·범위 | 독자가 읽을 의미 |
|---|---|---|
| 랙 토큰 처리량 최대 7배 | Maia 200 대비, Maia 300의 전체 96개 가속기 구성 | 한 랙이 감당할 수 있는 총 추론 처리량 |
| 메가와트당 토큰 40% 증가 예상 | 주요 GPU 기반 시스템 대비 | 같은 전력 규모에서 처리하는 토큰의 증가 전망 |
7배 비교에는 랙당 가속기가 48개에서 96개로 늘어난 구성 변화가 함께 들어갑니다. 개인이 보내는 질문 한 건의 응답 시간은 모델·문맥 길이·동시 요청 등에 따라 달라집니다. 발표는 전체 랙 처리량을 설명하며, 40% 수치는 Microsoft의 기대치로 제시합니다. 주요 GPU 기반 시스템의 구체적인 제품명과 동일 조건의 시험 결과는 해당 공식 발표에서 확인되지 않았습니다. 공식 발표 · 아키텍처 설명
제공·이용 조건: 2027년 배포 계획과 현재 서비스를 구분합니다
Microsoft는 2027년부터 Azure Maia 계열을 멀티 기가와트 규모로 확대하고, 자사 제품과 서비스의 주요 추론 시스템으로 삼겠다고 밝혔습니다. Maia 300의 생산 배포도 2027년에 시작할 예정입니다. 이번 발표에서 Maia 300을 고객이 직접 신청하는 주소, Azure에서 선택할 인스턴스, 고객 공개 프리뷰 일정, 한국 리전 제공 여부는 확인되지 않았습니다. 공식 발표
이미 운영 중인 세대는 Maia 200입니다. 1월 발표에서는 미국 Central 리전 배포와 다음 배포 지역인 US West 3, Maia 200 SDK 프리뷰를 안내했습니다. SDK에는 PyTorch 연동, Triton 컴파일러, 커널 라이브러리와 저수준 프로그래밍 도구가 포함됩니다. 이 개발 도구의 프리뷰는 Maia 200을 대상으로 합니다. 1월 Maia 200 발표와 프리뷰 안내
10월 발표에서는 Maia 200이 미국·유럽·호주에 배포되고 있으며 Microsoft Copilot과 자체 모델 개발 팀인 MAI의 실제 운영 작업을 처리한다고 설명합니다. GitHub Copilot과 Microsoft Foundry는 연말까지 뒤따를 계획입니다. Azure로 AI 앱을 만드는 팀은 자신이 쓰는 모델·서비스의 리전과 이용 조건을 확인하면 됩니다. 이번 하드웨어 발표에는 고객이 바꿔야 할 설정이나 이전 절차가 제시되지 않았습니다. 공식 발표
비용·요금: 고객 가격은 미확인입니다
Maia 300의 구매 가격, 시간당 임대료, 고객용 토큰 요금과 한국 원화 가격은 이번 공식 발표에서 확인되지 않았습니다. Microsoft가 강조하는 전력당 처리량과 운영 효율은 데이터센터 설계의 목표입니다. Copilot 구독료나 Microsoft Foundry의 모델별 API 가격 변경은 이 발표에 제시되지 않아, 실제 비용은 이용할 서비스의 요금표로 확인해야 합니다. 공식 발표 · 아키텍처 설명
반응 (2026년 10월 13일 기준)
공개된 사용자 반응은 아직 확인되지 않았습니다.
함께 읽기
긴 문맥을 실제 코딩 도구에서 어떻게 제공하는지 궁금하다면 코덱스 Day 7의 기본 문맥 500K와 이용 조건을 함께 읽을 수 있습니다. 하드웨어가 처리하도록 설계된 작업과 개별 서비스가 제공하는 문맥 한도를 각각 살펴볼 수 있습니다.
참고한 자료
확인일: 2026년 10월 13일. 사양·성능 수치와 배포 계획의 발표자는 Microsoft입니다.