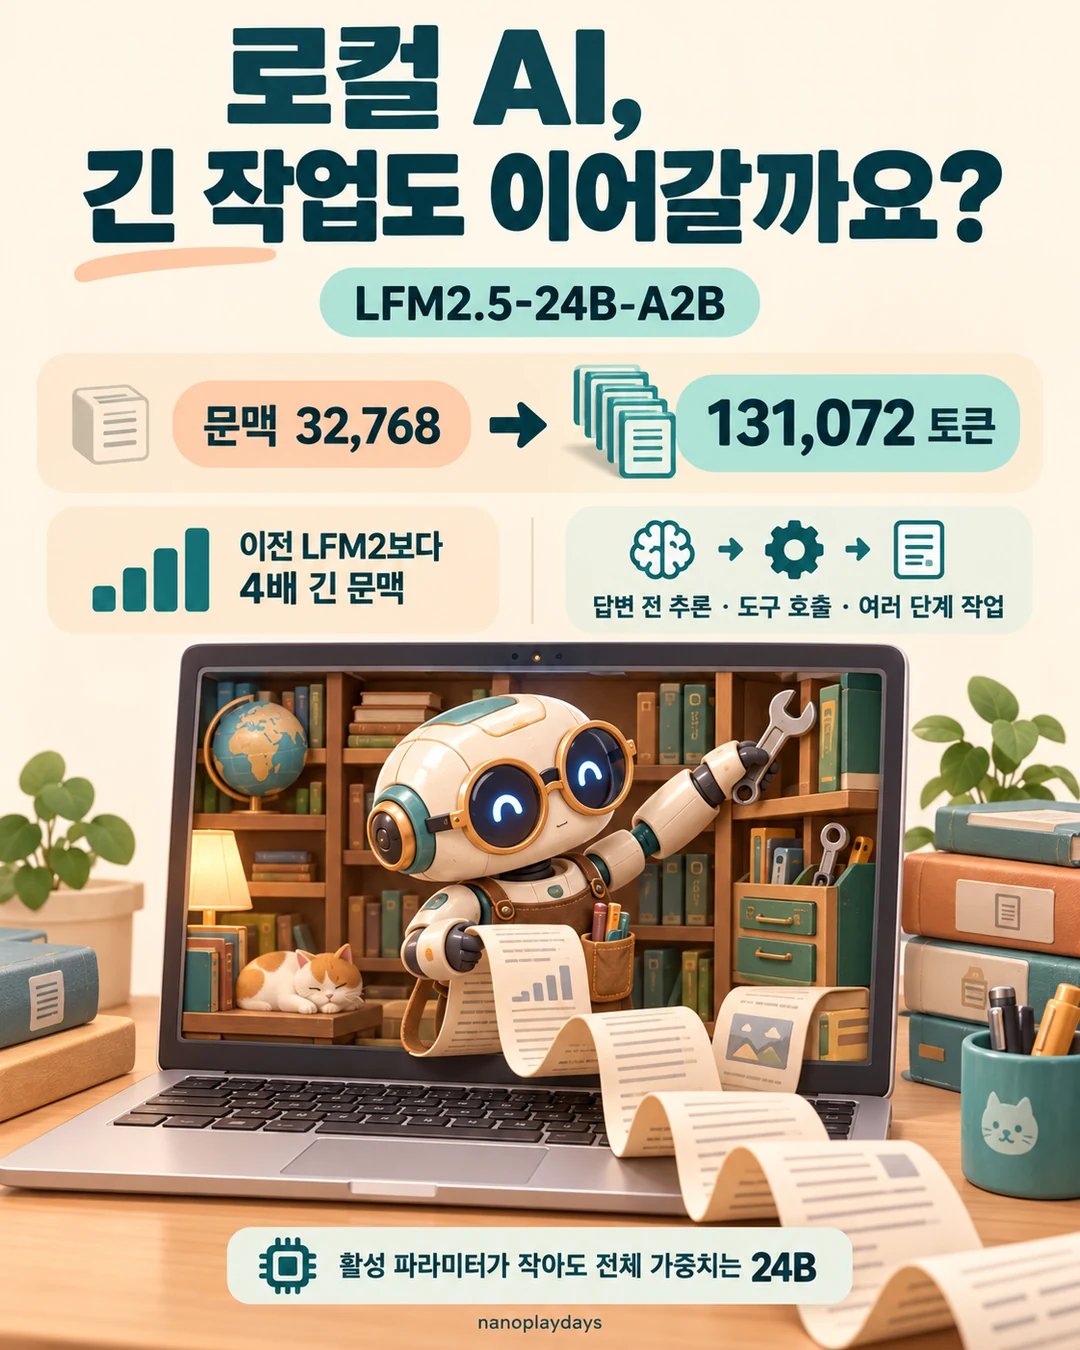
내 PC에서 AI가 긴 작업 기록을 읽고, 필요한 도구를 부르며 일을 이어가길 바라나요? Liquid AI는 10월 13일 LFM2.5-24B-A2B를 공개했습니다. 이전 LFM2-24B-A2B보다 문맥을 4배 늘리고, 답변 전에 추론하는 방식으로 바꾼 텍스트 모델입니다. 모델 가중치를 내려받아 로컬 에이전트에 연결할 수 있습니다. 공식 소개
도구 호출과 지시 이행은 눈여겨볼 부분입니다. 다만 제작사의 평가에서도 웹 작업과 코드 수정에서는 비교 모델이 앞섭니다. 로컬 AI를 고를 때는 생성 속도에 더해 내가 맡길 작업의 성공률을 함께 볼 필요가 있습니다. 아래 수치와 이용 조건은 2026년 10월 14일 확인 기준입니다. 공식 평가표
문맥 4배, 답변 전 추론: 이전 모델과 달라진 점
‘문맥’은 모델이 한 번의 작업에서 참조할 수 있는 대화·자료의 토큰 범위입니다. 토큰은 글을 모델이 처리하는 단위이며, 언어에 따라 글자 수와의 비율이 달라집니다. LFM2.5는 131,072토큰을 안내합니다. 이전 모델 카드의 32,768토큰과 비교하면 4배입니다. 긴 대화와 도구 실행 결과를 담을 공간이 늘었지만, 긴 자료에서 필요한 내용을 정확히 찾는지는 별도로 시험할 수 있습니다. 이전 모델 카드 · 새 모델 카드
이전 모델은 추론 과정을 내보내지 않는 지시형 모델이었고, 새 버전은 최종 답변 앞에 명시적 추론을 생성하는 reasoning-only 모델로 소개됩니다. 짧은 답만 필요한 일에도 추론 토큰과 시간이 들 수 있습니다. 공식 소개에는 추론을 끄는 설정이나 단계별 추론 강도 옵션이 없습니다. 기본 예제는 temperature=0.1, top_k=50, repetition_penalty=1.05를 사용합니다. temperature는 생성의 무작위성을 조절하며, 이 값은 아래 벤치마크의 공통 설정과 구분됩니다. 구조·생성 예제
전체 크기 24B는 약 240억 매개변수를 뜻합니다. MoE(Mixture of Experts)는 토큰마다 일부 전문가만 골라 계산하는 구조입니다. 이번 모델은 40개 층과 MoE 블록당 64개 전문가, 그중 4개를 선택하는 구조를 유지합니다. 짧은 범위의 정보를 처리하는 합성곱과 여러 쿼리가 키·값을 공유하는 GQA 어텐션을 함께 씁니다. 한 토큰을 만들 때 계산하는 부분은 작아도, 저장하고 불러올 전체 가중치의 크기는 24B를 기준으로 봅니다. 모델 구조
자료별 숫자도 구분할 필요가 있습니다. 소개 글은 활성 매개변수 2B와 사전학습 약 33T 토큰을 쓰고, 모델 카드는 학습 설명에서 같은 33T를 쓰면서 상세 항목에는 활성 2.45B와 학습 예산 36T를 표기합니다. 소개 글에는 사전학습 뒤 32K 문맥으로 2T, 131K 문맥으로 300B 토큰을 추가하는 중간 학습도 나옵니다. 33T는 소개 글의 사전학습 수치, 36T는 카드의 학습 예산 표기로 읽으며, 두 값의 정확한 집계 차이는 공개 설명만으로 확정하기 어렵습니다. 학습 단계 설명 · 상세 수치
토크나이저의 어휘도 소개 글 기준 약 65K에서 128K로 늘었습니다. 회사는 비라틴 문자 처리를 개선하기 위한 확장이라고 설명합니다. 새 모델의 지원 언어 목록에는 한국어가 포함되지만, 한국어 업무의 정확도나 토큰 절감률은 따로 제시하지 않았습니다. 한국어 문서 요약·검색에 쓰려면 자신의 입력으로 답의 근거와 누락을 확인하는 것이 다음 단계입니다. 어휘 확장 설명 · 언어 목록
도구 호출·웹 작업·코딩 점수는 어떻게 다릅니까?
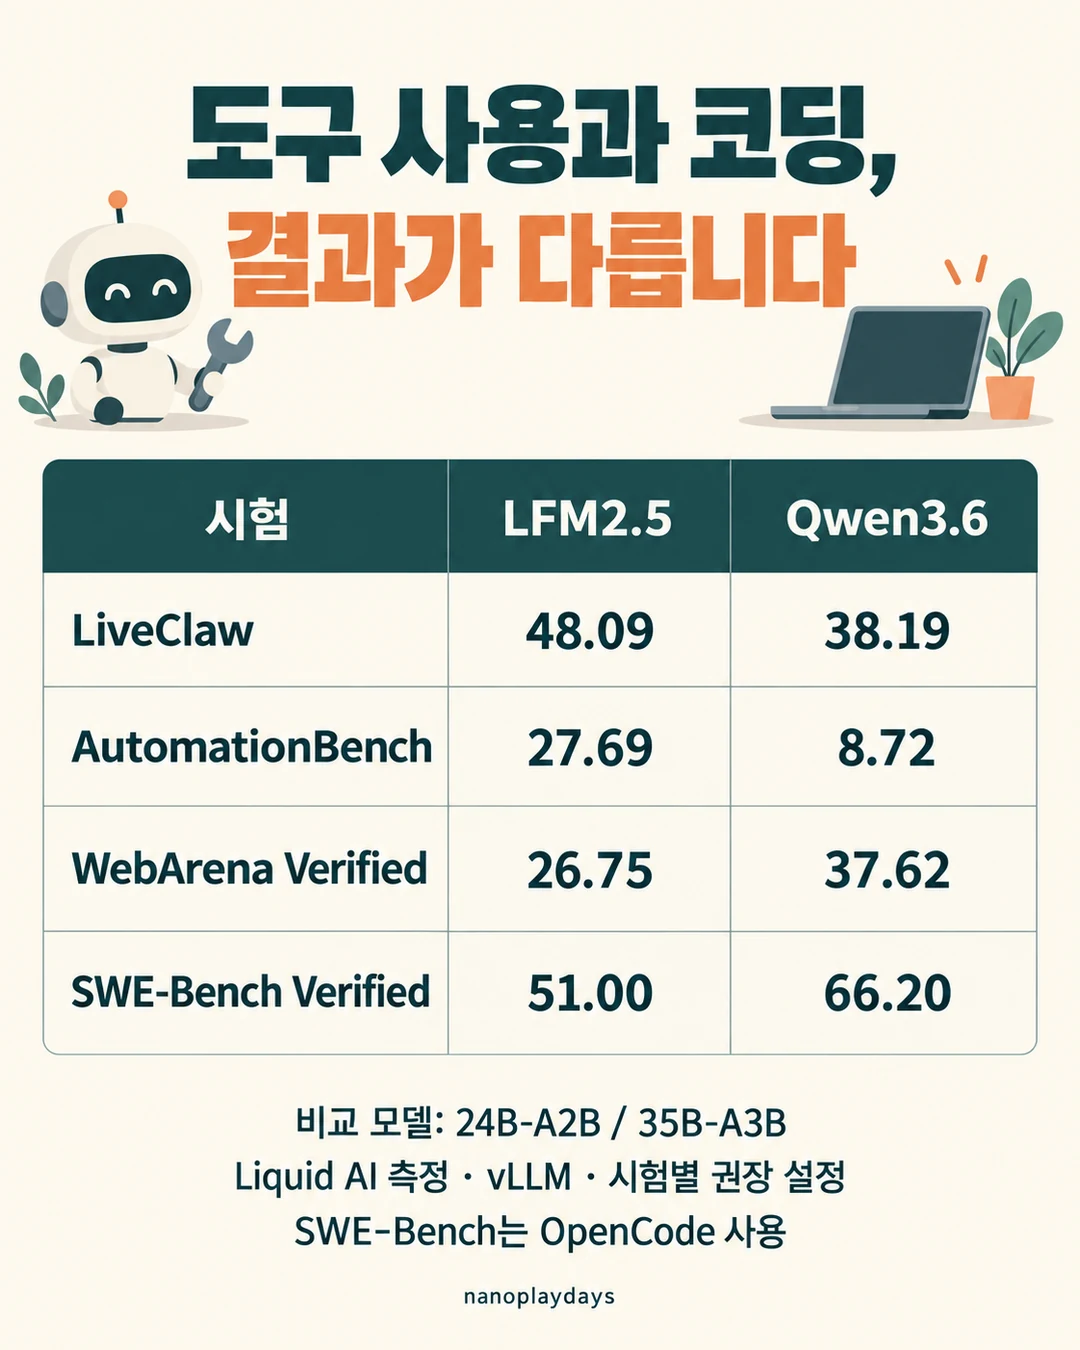
Liquid AI는 16개 시험에서 Qwen3.6-35B-A3B, Gemma-4-26B-A4B-it, Nemotron-3.5-Lightning과 비교했습니다. 아래는 LFM2.5와 Qwen을 나란히 읽은 제작사 측정값입니다. 모든 모델을 vLLM으로 실행하고 시험별 권장 생성 설정을 사용했다고 밝힙니다. 독립 평가기관의 재현 점수는 이번 자료에 없습니다. 평가표와 조건
| 시험 | LFM2.5-24B-A2B | Qwen3.6-35B-A3B |
|---|---|---|
| AutomationBench | 27.69 | 8.72 |
| BFCLv4 | 65.01 | 65.00 |
| ToolSandbox | 80.71 | 75.02 |
| LiveClaw | 48.09 | 38.19 |
| PinchBench | 83.18 | 89.93 |
| τ³-Bench Banking | 8.04 | 7.63 |
| WebArena Verified | 26.75 | 37.62 |
| GPQA Diamond | 74.42 | 83.69 |
| AA-Omniscience | -24.90 | -24.35 |
| HLE | 7.40 | 7.69 |
| IFEval | 96.75 | 93.06 |
| IFBench | 74.69 | 64.21 |
| Multi-IF | 84.38 | 81.53 |
| MATH-500 | 96.04 | 96.73 |
| SWE-Bench Verified (OpenCode) | 51.00 | 66.20 |
| SciCode | 32.71 | 37.35 |
도구와 에이전트 평가에서는 결과가 갈립니다. 함수를 골라 호출하는 BFCLv4는 거의 같은 점수이고, LiveClaw와 AutomationBench에서는 LFM2.5가 높습니다. 반면 PinchBench와 웹 작업을 다루는 WebArena Verified에서는 Qwen이 높습니다. 회사의 ‘8개 중 5개에서 앞서거나 비슷하다’는 설명은 이 비교표의 범위를 가리킵니다. 도구·에이전트 평가 설명
코드 수정 작업이라면 SWE-Bench Verified 행이 더 직접적입니다. OpenCode 환경에서 LFM2.5는 51.00, Qwen은 66.20을 기록했습니다. 과학 분야 코드를 다루는 SciCode도 Qwen이 높습니다. 복잡한 지식 질문을 다루는 GPQA Diamond·HLE와 지식 평가 AA-Omniscience에서도 LFM2.5가 Qwen을 앞서지 못했습니다. 반대로 IFEval·IFBench·Multi-IF의 지시 이행 점수는 LFM2.5가 높고, MATH-500은 96.04와 96.73으로 비슷합니다. 필요한 도구와 출력 형식이 분명한 반복 작업부터 시험하고, 어려운 코드 수정·지식 판단은 각각의 점수와 실제 결과를 확인할 수 있습니다. 지식·지시 이행·코딩 평가
시험마다 설정도 다릅니다. 공식 출시 글은 AutomationBench에 temperature 0.6·top_p 0.95, LiveClaw에 temperature 1.0·최대 출력 8,192토큰, WebArena에 temperature 0.6·top_p 0.95·최대 40턴을 안내합니다. 일부 시험은 출력 한도를 문맥 범위에 맡깁니다. 점수를 재현하려면 평소 대화용 기본값 대신 해당 시험의 조건을 맞춰야 합니다. 출시 글의 평가 설정
184 tok/s와 21K tok/s는 서로 다른 속도입니다
tok/s는 초당 생성 토큰 수입니다. 소개 글은 Apple M5 Max에서 184, AMD Ryzen AI Max+ 395에서 114를 보고합니다. 비교한 MoE들 중 최대 1.7배 빠르다는 설명도 있습니다. 모델 카드는 이 기기 측정에 4비트급 Q4_K_M 양자화 가중치를 썼다고 밝히지만, 메모리 사용량과 입출력 길이 조건은 적지 않았습니다. 내 PC의 예상 속도로 바로 대입하기에는 확인할 조건이 남습니다. 기기별 속도 소개 · 측정 형식
NVIDIA B300 한 장에서 21K 이상의 출력 tok/s는 많은 요청을 동시에 처리한 전체 처리량입니다. 공식 출시 글의 조건은 SGLang 0.5.22, BF16, 입력 1,024토큰, 최대 출력 256토큰입니다. 완료된 요청을 곧바로 새 요청으로 교체해 동시 요청 수를 유지합니다. 한 사람이 질문 하나에 받는 답변 속도를 알고 싶다면 개별 요청 지연을 따로 측정합니다. B300 시험 조건
로컬에서 긴 문맥을 사용할 때는 가중치뿐 아니라 작업 중 보관하는 문맥 캐시와 실행 여유 메모리도 필요합니다. 활성 매개변수 2B라는 소개만 보고 작은 2B 모델의 메모리를 기대하기보다, 선택한 가중치 형식과 문맥 길이로 RAM·VRAM을 확인하는 편이 맞습니다. 이 버전의 환경별 최소 메모리는 확보된 공식 소개 텍스트에서 확인되지 않았습니다. 구조·실행 예제
제공·이용 조건: 어디서 시작합니까?
가중치는 LFM2.5-24B-A2B와 Base 버전으로 공개됐습니다. 에이전트에 바로 연결할 목적이면 후학습된 LFM2.5-24B-A2B를, 별도 학습·개조 목적이면 Base를 살펴볼 수 있습니다. 공식 출시 글은 Playground 체험도 안내합니다. 한국 지역의 별도 제한은 공개 소개에 없으며, 한국 계정의 서비스 접속·결제 상태는 미확인입니다.
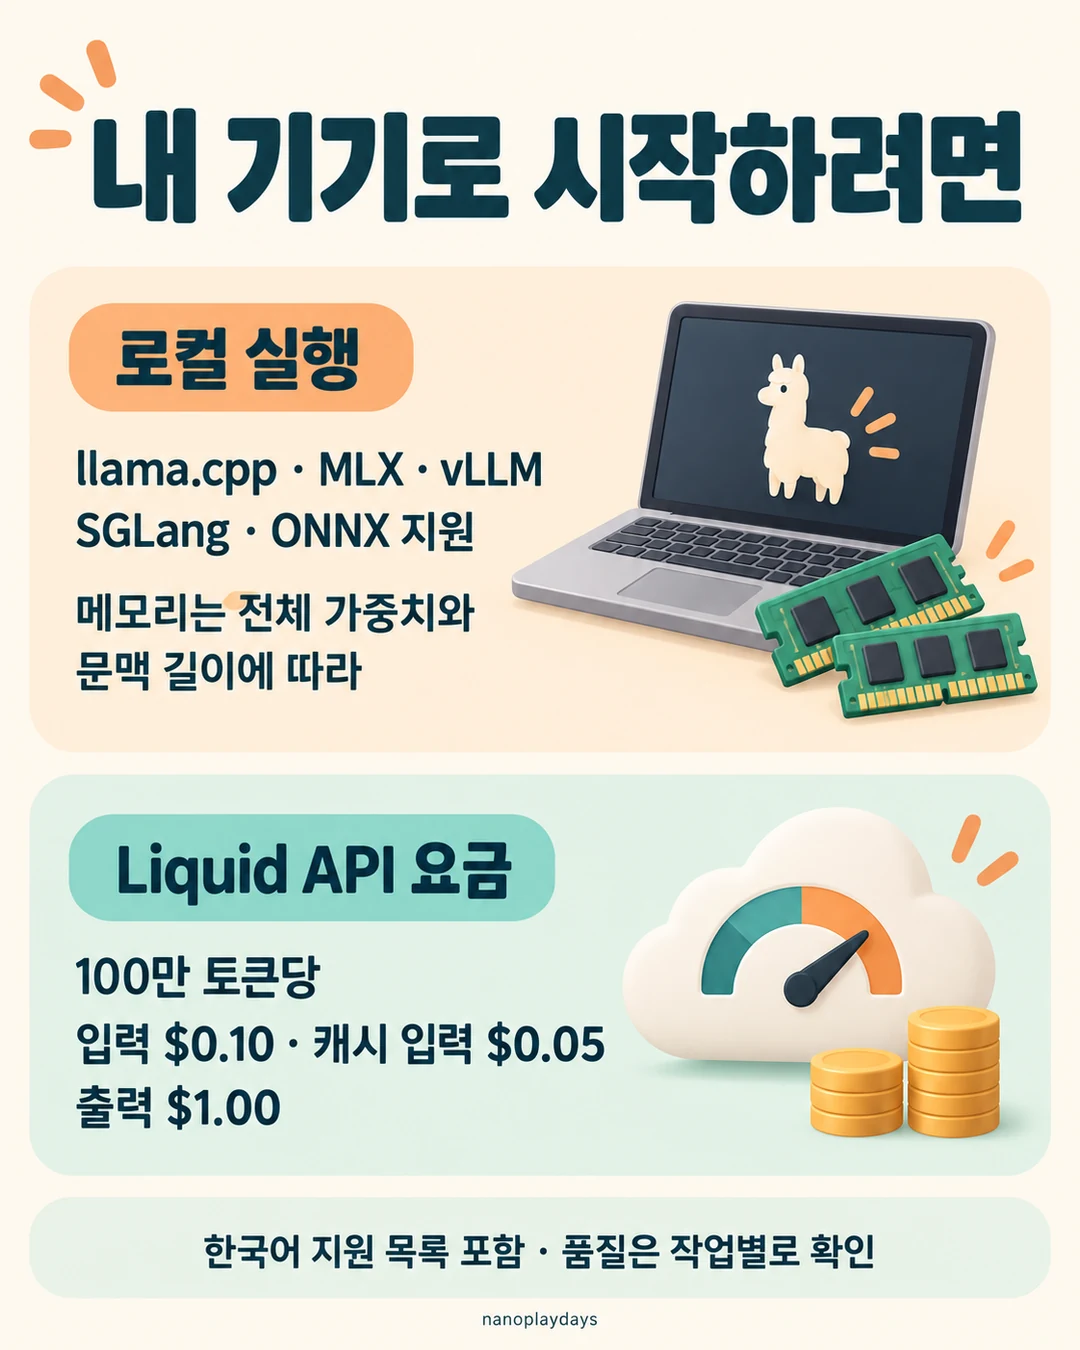
로컬 실행 지원은 llama.cpp·MLX·vLLM·SGLang·ONNX로 안내됩니다. GGUF는 llama.cpp 계열 실행에, MLX는 Apple Silicon 실행에 활용하는 형식·도구입니다. Transformers 예제는 5.0.0 이상과 최신 버전 설치를 안내합니다. 설치 뒤 모델 ID를 LiquidAI/LFM2.5-24B-A2B로 지정하고 해당 토크나이저의 apply_chat_template를 사용합니다. 이전 모델의 토크나이저와 설정을 그대로 복사하기보다 새 모델의 예제로 시작할 수 있습니다. 지원 엔진·Transformers 예제
pip install -U transformers
공식 Hermes Agent 예제는 먼저 로컬 서버를 실행한 뒤 OpenAI 호환 API에 연결합니다. 제공자 custom, 모델 LFM2.5-24B-A2B, 문맥 길이 131072, API 모드 chat_completions와 도구 사용 옵션을 지정합니다. 예제의 포트는 llama.cpp·MLX 8080, vLLM 8000, SGLang 30000, LM Studio 1234이며 실제 서버 설정에 따라 달라집니다. 모델만 내려받는 것과 검색·파일 처리 도구까지 연결해 작업하는 과정은 나눠 준비합니다. Hermes 연결 예제
로컬 추론은 모델 입력을 클라우드 추론 API로 보내지 않는 구성을 만들 수 있습니다. 다만 에이전트에 외부 검색이나 클라우드 도구를 연결하면 해당 도구가 전달받는 데이터는 별도입니다. 파일 변경·명령 실행 권한과 확인 절차도 에이전트 쪽에서 정합니다. 처음에는 읽기 전용 자료 검색처럼 결과를 검토하기 쉬운 작업으로 연결을 확인할 수 있습니다.
비용·요금: 로컬 실행과 API를 나눠 봅니다
로컬에서는 보유 기기의 메모리·전력과 운영 시간이 비용에 들어갑니다. Liquid API의 토큰 가격을 로컬 실행료로 적용하지 않습니다. 가중치는 LFM Open License v1.0으로 배포됩니다. 상업 이용은 연 매출 1,000만 달러 미만인 개인·법인에만 허용되며, 이 기준 이상인 법인의 상업 이용은 라이선스 범위 밖입니다. 출시 글의 ‘제한 없이 배포’라는 표현과 달리 매출 조건이 있으므로, 회사 서비스에 넣기 전에는 라이선스 원문의 비영리 예외와 파생 모델 조건까지 확인할 필요가 있습니다.
Liquid Console을 통한 API는 입력 100만 토큰당 $0.10, 캐시 입력 $0.05, 출력 $1.00으로 발표했습니다. 캐시 입력은 재사용 가능한 입력이 서비스의 캐시 조건을 충족한 경우에 해당합니다. 가입 시 $2 크레딧도 안내합니다. API 가격·시작 안내
예를 들어 캐시 없는 입력 10만 토큰과 출력 1만 토큰을 처리하면 입력 $0.01과 출력 $0.01, 합계 $0.02입니다. 발표 단가로 계산한 예시이며 실제 청구액·환율·세금은 별도입니다. 추론하는 동안 생성하는 분량까지 고려해 작업당 전체 사용량을 확인하면, 짧은 최종 답변만 보고 비용을 예상하는 일을 줄일 수 있습니다.
반응 (2026년 10월 14일 확인 기준)
r/LocalLLaMA의 공개 토론에는 빠른 로컬 실행에 대한 기대와 서로 다른 첫 사용기가 함께 나옵니다. 일부 사용자는 RTX 2060에서 20~25 tok/s를 보고했고, 다른 사용자는 RTX 3090의 특정 설정에서 186 tok/s와 VRAM 14.4GB를 적었습니다. 각자의 설정·입력으로 낸 개인 보고여서 두 그래픽카드의 공통 조건 비교로 읽기는 어렵습니다.
도구 사용에 대해서는 웹 검색 첫 시험 다섯 번이 모두 실패했다는 경험이 있고, Qwen과의 벤치마크 비교가 실제 사용 감각과 맞는지 의문을 제기한 의견도 있습니다. 한편 빠른 Qwen 대안이 될지 기대하는 댓글도 확인됩니다. 속도에 관한 호평과 작업 성공률에 관한 의문이 함께 있는 초기 토론입니다. 점수·전체 댓글 수는 확인되지 않았고, 한국어 실사용 후기도 찾지 못했습니다. 사용자 경험·의견 원문
로컬 에이전트가 목적이라면 자신이 쓰는 한국어 자료와 도구 한두 개로 시작해, 작업 성공 여부·입력 길이·메모리·전체 생성 토큰을 함께 기록할 수 있습니다. 선택지 분류처럼 정해진 결과만 필요한 업무는 Liquid AI d1 결정 모델의 입력과 제약과도 비교해 볼 수 있습니다. LFM2.5의 긴 대화·추론 기능이 필요한지, 더 작은 결정 모델로 끝낼 수 있는지 판단하는 데 도움이 됩니다.
참고한 자료
- Hugging Face 공식 소개 — 2026-10-13 발표, 구조·학습 단계·16개 평가·속도·실행 예제. 2026-10-14 확인.
- Liquid AI 공식 출시 글 — B300 처리량 시험 조건·벤치마크 설정·API 가격·Playground 안내. 2026-10-14 확인.
- LFM2.5-24B-A2B 모델 카드 — 활성 2.45B·학습 예산 36T·문맥·언어 목록·기기 측정 Q4_K_M. 2026-10-14 확인.
- LFM Open License v1.0 — 연 매출 1,000만 달러 기준의 상업 이용 조건. 2026-10-14 확인.
- 이전 LFM2-24B-A2B 모델 카드 — 문맥 32,768토큰과 지시형 동작. 2026-10-14 확인.
- r/LocalLLaMA 토론 — 개인 속도 보고·웹 검색 사용기·비교 의견. 2026-10-14 확인.