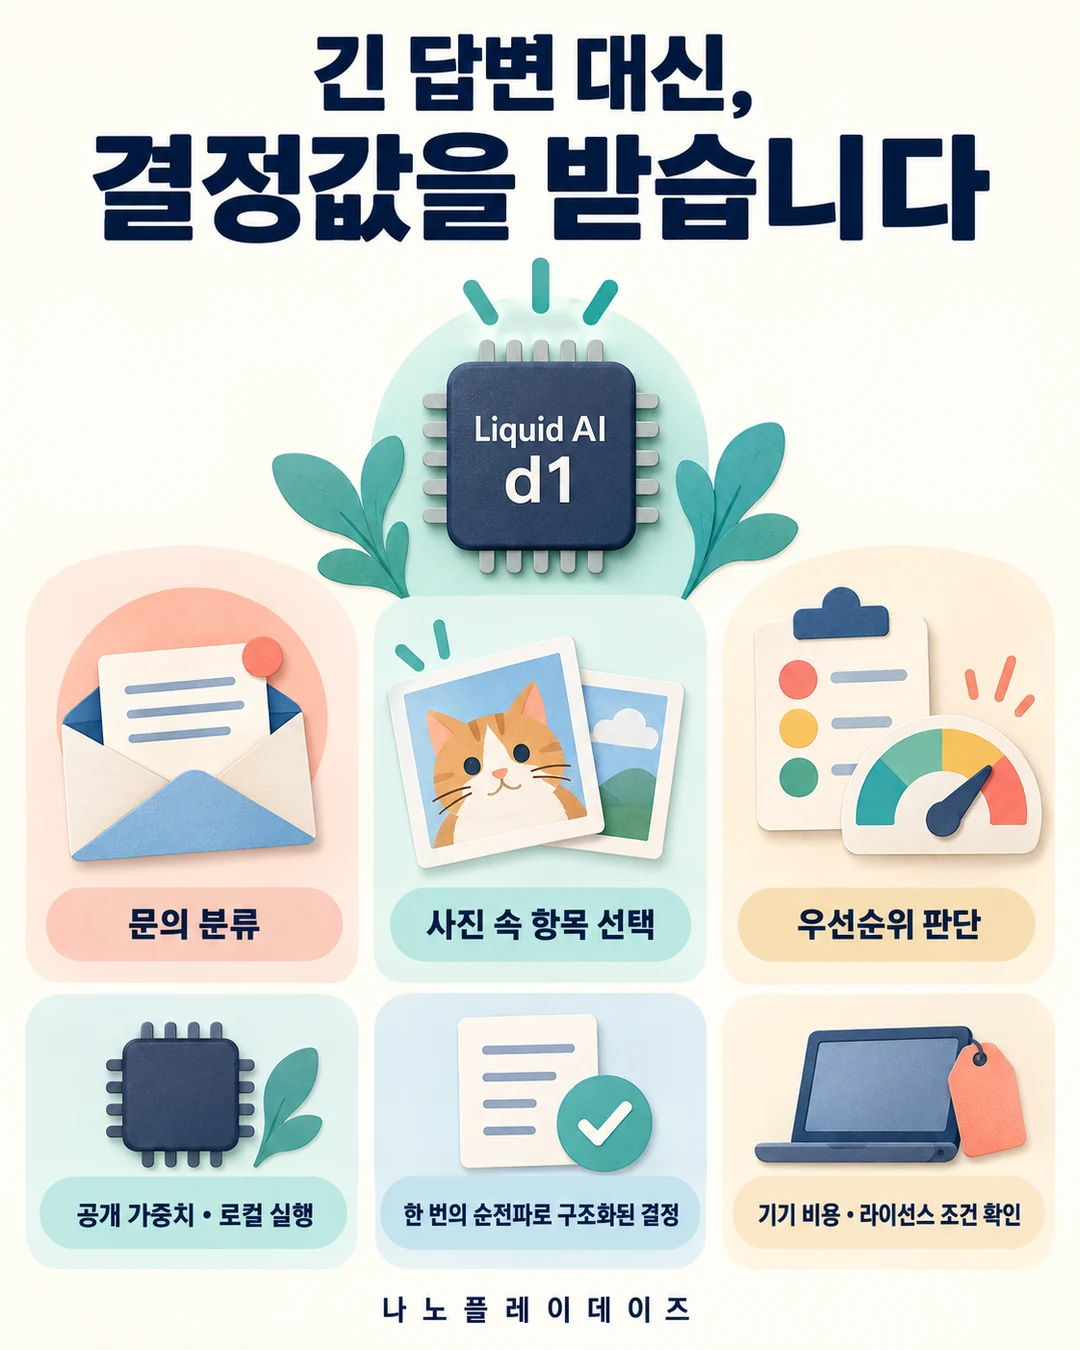
고객 문의를 분류하거나 사진에서 정해진 항목을 고를 때, 긴 답변 대신 결정값을 받는 작은 모델을 로컬에서 써 볼 수 있게 됐습니다. Liquid AI는 2026년 10월 7일 d1-3B와 실험 모델 d1-omni-600M의 가중치를 공개했다고 발표했습니다. 두 모델은 입력을 읽어 한 번의 계산으로 답하는 결정 모델입니다. 이번 공개에 대한 사용자 토론은 아직 확인되지 않았습니다. (공개 발표)
한눈에 보기
| 궁금한 점 | 이번 발표의 핵심 |
|---|---|
| 무엇을 공개했습니까? | d1-3B와 초기 연구 단계의 d1-omni-600M 공개 가중치입니다. |
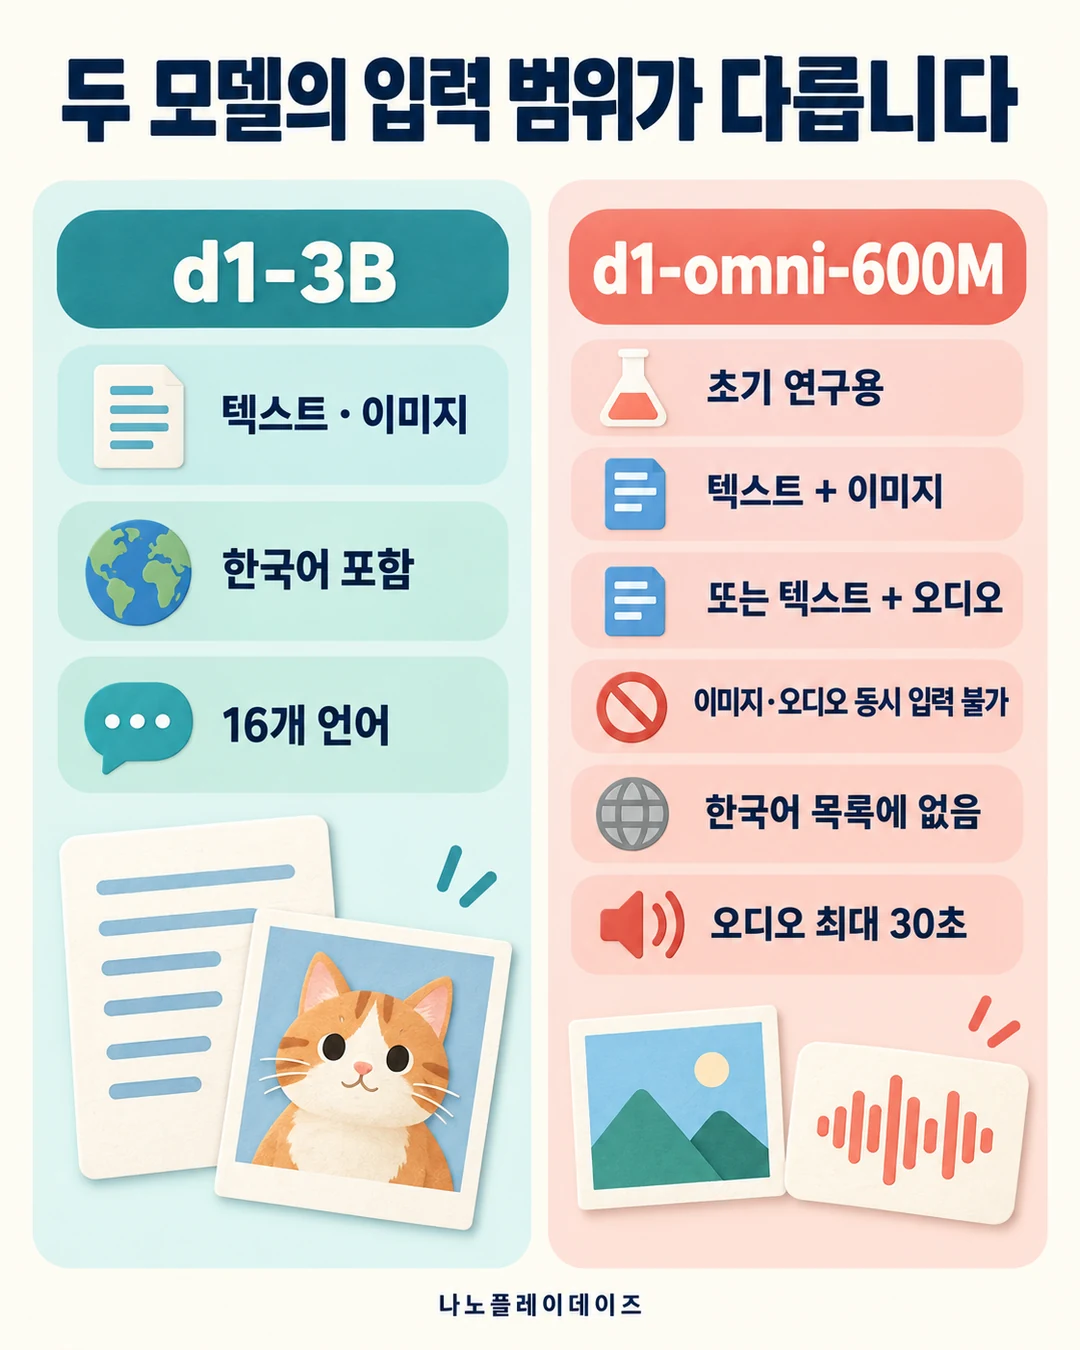
| 입력은 무엇입니까? | d1-3B는 텍스트·이미지, omni는 텍스트와 이미지 또는 텍스트와 오디오를 받습니다. omni는 한 요청에 이미지와 오디오 중 하나만 받습니다. |
| 한국어를 지원합니까? | d1-3B 모델 카드의 16개 언어에 한국어가 있습니다. omni의 15개 언어 목록에는 한국어가 없습니다. |
| 답변 방식은 무엇입니까? | 토큰을 순서대로 생성하지 않고 한 번의 순전파로 구조화된 결정을 계산합니다. |
| 어디에 활용합니까? | 분류, 정해진 선택지 고르기, 점수 판단 등 빠른 결정이 필요한 작업을 안내합니다. |
| 평가 수치는 어떻습니까? | 업체가 보고한 Decision Index 0.2.1에서 d1-3B는 48.57점입니다. 시각·오디오 평가 수치는 제시하지 않았습니다. |
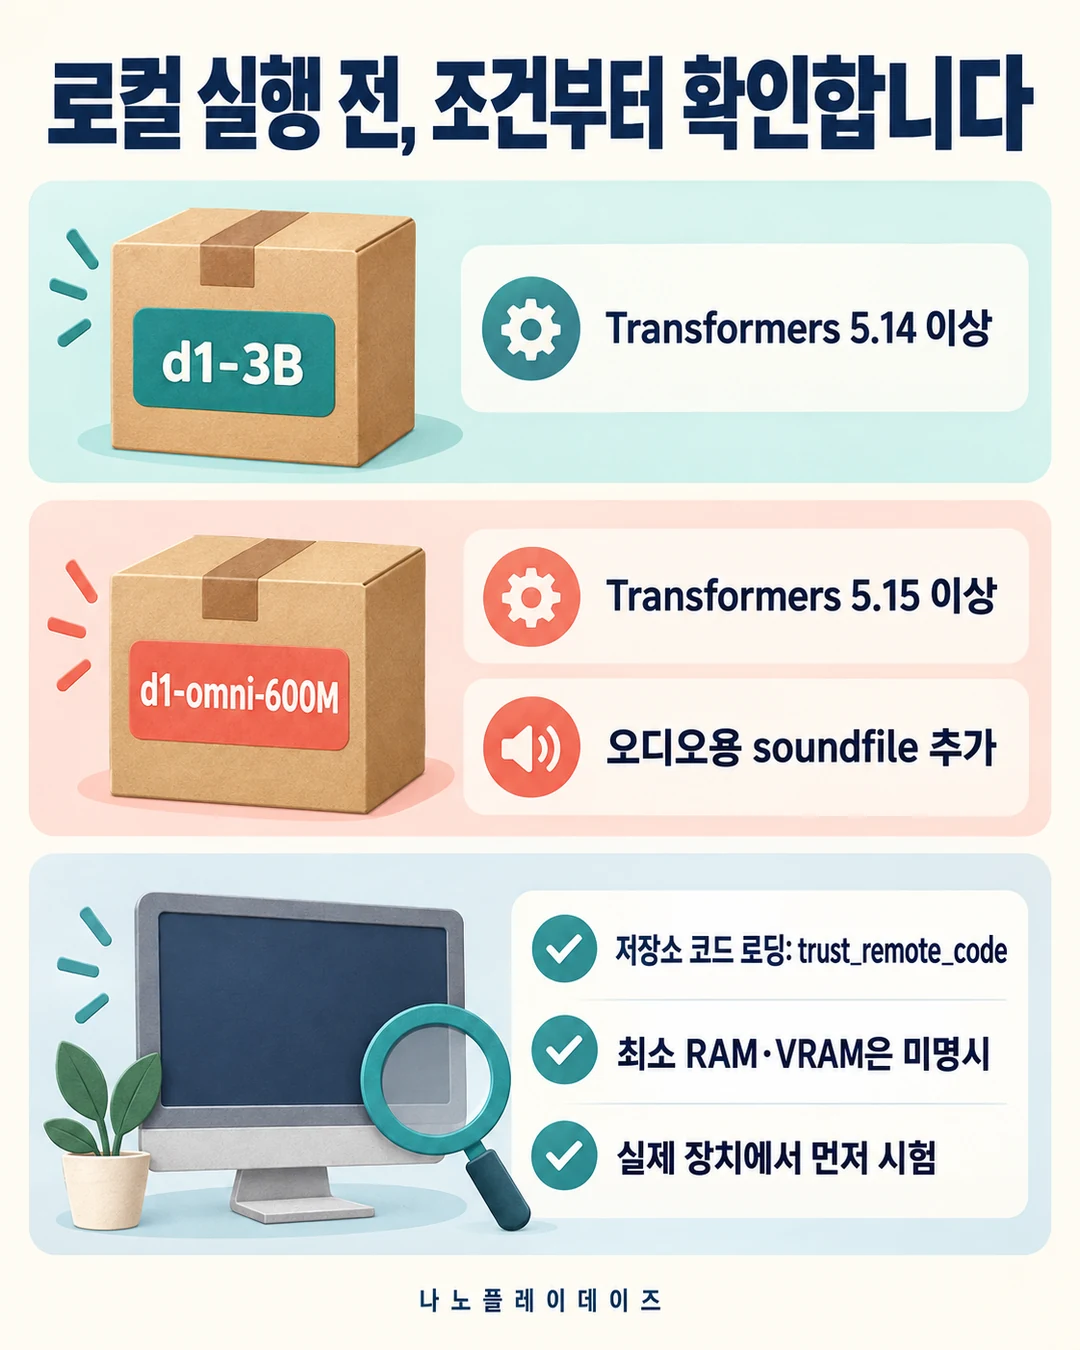
| 실행 조건은 무엇입니까? | d1-3B는 Transformers 5.14 이상, omni는 5.15 이상과 모델 저장소 코드(trust_remote_code)를 씁니다. |
| 기기 조건은 무엇입니까? | Jetson·GPU·Apple M5 Pro 측정값은 있지만 최소 메모리는 모델 카드에 적혀 있지 않습니다. |
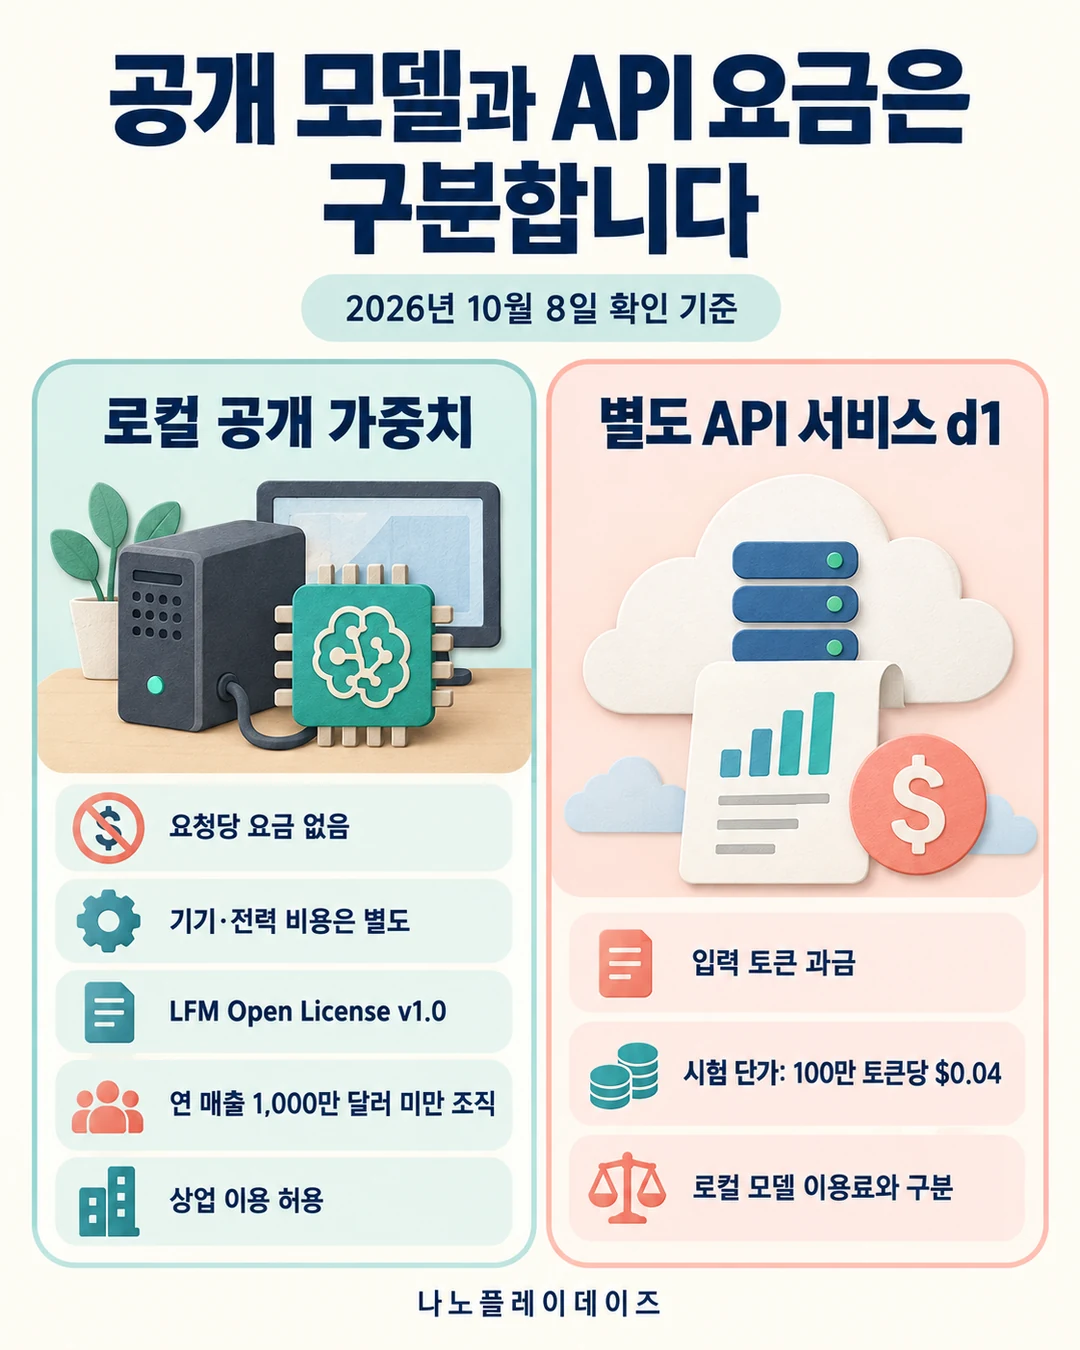
| 비용과 라이선스는 어떻습니까? | 두 모델 모두 LFM Open License v1.0입니다. 상업 이용은 연 매출 1,000만 달러 미만 조직에 허용됩니다. |
모델 구조·평가·속도는 Liquid AI의 공개 발표를, 언어·라이선스·입력 제약은 두 모델 카드를 따릅니다. 수치는 공급자 측 시험이며 독립 재현 결과와 구분합니다. 별도 API 서비스 d1의 과금 안내는 공개 모델과 나눠 설명합니다. 확인일은 2026년 10월 8일입니다. (공개 모델 발표 · d1-3B 모델 카드 · d1-omni-600M 모델 카드 · API 서비스 안내)
결정 모델은 일반 대화 모델과 어떻게 다릅니까?
일반 생성 모델은 입력을 받은 뒤 답변의 토큰을 하나씩 이어 만듭니다. 결정 모델은 상황과 질문, 가능한 답의 기준을 함께 받아 선택에 필요한 값을 계산합니다. ‘순전파’는 입력이 모델의 계산 층을 지나 결과로 나오는 한 차례의 처리입니다. Liquid AI는 공개 d1 모델이 토큰 생성 없이 한 번의 순전파로 답한다고 설명합니다. (공개 모델 구조)
예를 들어 고객이 “이번 달 결제가 두 번 됐으니 하나를 환불해 주세요”라고 보냈을 때, 환불 요청인지 판단하고 담당 부서를 정하며 긴급도를 매기는 흐름입니다. 개발자가 반환받고 싶은 항목을 미리 정하면 서비스의 다음 단계로 연결하기 쉽습니다. 공개 예제에는 같은 문장에 여러 이름의 질문을 붙여 한 번에 처리하는 코드와 여러 요청을 묶는 배치 코드가 나옵니다. (고객 문의·배치 예제)
Liquid AI는 질문 유형을 noul, choice, score로 부릅니다. noul은 예·아니오 질문의 확률, choice는 여러 라벨의 선택 확률, score는 단계별 확률을 반영한 척도상의 값을 표현합니다. 개발자는 글을 생성한 뒤 JSON을 파싱하는 흐름 대신, 환불 여부·부서·긴급도처럼 정해진 결과를 요청하는 방식으로 설계를 바꿀 수 있습니다. 각 확률의 운영 기준은 실제 문의 자료와 정답 라벨을 놓고 정할 수 있습니다. (질문 유형 설명)
두 모델의 입력과 개발 단계는 어떻게 다릅니까?
| 항목 | d1-3B | d1-omni-600M |
|---|---|---|
| 기반 모델 | LFM2.5-VL-3B | LFM2.5-Encoder-350M |
| 구조 설명 | 디코더 기반 | 양방향 인코더에 시각·오디오 인코더 추가 |
| 전체 매개변수 | 3.12B(BF16, safetensors) | 587M(공통 본체 381M, 시각 94M, 오디오 112M) |
| 입력 | 텍스트, 이미지 | 텍스트와 이미지 또는 텍스트와 오디오(동시 불가) |
| 언어 목록 | 16개, 한국어 포함 | 15개, 한국어 없음 |
| Transformers | 5.14 이상 | 5.15 이상(오디오용 soundfile 추가) |
| 공개 단계 | 공개 결정 모델 | 초기 연구용 실험 공개 |
| 속도 수치 | 여러 기기의 측정표 제공 | 개발 중이라 미제시 |
‘백본’은 새 모델이 출발점으로 삼은 기반 구조입니다. d1-3B는 시각 언어 모델 LFM2.5-VL-3B를 바탕으로 텍스트와 사진을 다룹니다. 디코더 기반 모델에서 출발했더라도 이번 결정 모델의 출력 방식은 토큰 생성과 구분됩니다. 발표 예제는 사진 한 장을 상황 입력으로 넣고 고양이 수를 선택지 중에서 고르는 방식도 보여 줍니다. (모델 구조·사진 예제)
omni는 LFM2.5-Encoder-350M을 바탕으로 시각·오디오 인코더를 더했습니다. 양방향 인코더는 입력의 앞뒤 관계를 함께 읽는 구조를 가리킵니다. 발표가 명시한 조합은 텍스트와 이미지, 또는 텍스트와 오디오입니다. 모델 카드는 한 요청에 이미지와 오디오를 함께 넣으면 ValueError가 난다고 밝힙니다. 오디오는 30초까지 받고, 영어 화자와 어시스턴트 사이의 요청으로 학습했습니다. 이미지가 있을 때는 상황·질문 텍스트를 학습 때와 같이 896토큰으로 자릅니다. GPU에서는 float16을 권하고, bfloat16은 텍스트 0.8%, 오디오 1.7% 행에서 최상위 답을 바꿨다며 피하라고 안내합니다. 회사는 이 모델을 개발이 진행 중인 초기 연구 공개로 소개합니다. 한국어 음성이나 긴 문서를 이미지와 함께 판단하려는 개발자에게는 이 제약이 먼저 걸립니다. (omni 공개 범위 · omni 모델 카드)
평가 수치로 어떤 일을 판단할 수 있습니까?
Liquid AI는 Decision Index 0.2.1에서 d1-3B가 48.57점을 기록해 비교한 4B·9B 모델들과 Decider 35B-A3B의 47.11점을 앞섰다고 주장합니다. 같은 지표에서 omni는 모델 카드 기준 15.95점으로 d1-3B보다 크게 낮습니다. 아래 7개 데이터셋의 평균은 Decision Index와 다른 점수입니다. 각각의 평가 안에서 모델을 비교할 수 있습니다. (Decision Index 보고)
| 공개 발표의 평가 | d1-omni-600M | d1-3B | Decider 2B | Decider 4B |
|---|---|---|---|---|
| SQuAD 2.0 | 74.0 | 83.3 | 67.7 | 76.0 |
| Civil Comments | 95.8 | 93.3 | 93.6 | 92.8 |
| MASSIVE intent | 86.1 | 86.9 | 81.1 | 88.3 |
| PubMedQA | 61.3 | 68.3 | 65.7 | 63.3 |
| BoolQ | 77.7 | 86.3 | 87.3 | 89.0 |
| XNLI | 74.7 | 85.6 | 85.0 | 88.6 |
| PAWS-X | 79.5 | 76.4 | 59.5 | 69.8 |
| 업체 보고 평균 | 78.4 | 82.9 | 77.1 | 81.1 |
위 표는 독해, 유해 표현 감지, 의도 분류, 의료 질의응답, 언어 간 이해 등을 다루는 7개 공개 데이터셋에 대한 업체 보고입니다. 평균에서는 d1-3B가 높지만, MASSIVE intent와 BoolQ 등 개별 행에서는 다른 모델이 앞섭니다. 문의 분류에 쓸 개발자는 전체 평균과 의도 분류 행을 나눠 읽고 자신의 라벨로 시험할 수 있습니다. PubMedQA 점수는 데이터셋 질의응답 결과로, 실제 진료용 성능과 구분합니다. (평가 표 원문)
회사는 d1-3B가 기반 모델의 시각 능력을 표준 시각 벤치마크에서 유지했다고 설명하면서도 이번 발표에는 시각·오디오 결정 벤치마크 수치를 보고하지 않았습니다. 이유로 Decision Index v0.3의 시각 분할이 비공개이고, 오디오 결정 벤치마크가 아직 열린 과제라는 점을 듭니다. d1-3B 모델 카드에는 11개 공개 이미지 벤치마크 평균 74.1점(기반 LFM2.5-VL-3B 73.9점)이 적혀 있지만, 이것도 업체 집계이고 결정 작업 정확도와는 다른 지표입니다. 사진 검사·오디오 분류의 결정 정확도는 아직 공개되지 않았습니다. d1-3B 언어 목록에 한국어가 있어도 한국어 입력의 품질 수치는 발표와 카드 어디에도 없습니다. (멀티모달 평가 설명 · d1-3B 모델 카드)
작은 기기에서는 얼마나 빠릅니까?
발표의 d1-3B 속도 표는 짧은 질문, 긴 입력, 이미지 입력을 나눕니다. 아래 값은 Liquid AI 측정이며 모델 다운로드나 앱 전체 처리 시간과 구분합니다. NVIDIA 기기 평가는 NVIDIA와 협업했다고 밝힙니다. (속도 시험)
| 기기 | 질문 1개 | 질문 3개 | 3.4K 토큰 입력 | 384px 이미지 | 64건 묶음 처리 |
|---|---|---|---|---|---|
| Apple M5 Pro | 30ms | 41ms | 640ms | 62ms | 초당 78건 |
| Jetson AGX Thor | 16ms | 20ms | 220ms | 35ms | 초당 262건 |
| Jetson AGX Orin 64GB | 26ms | 35ms | 560ms | 83ms | 초당 110건 |
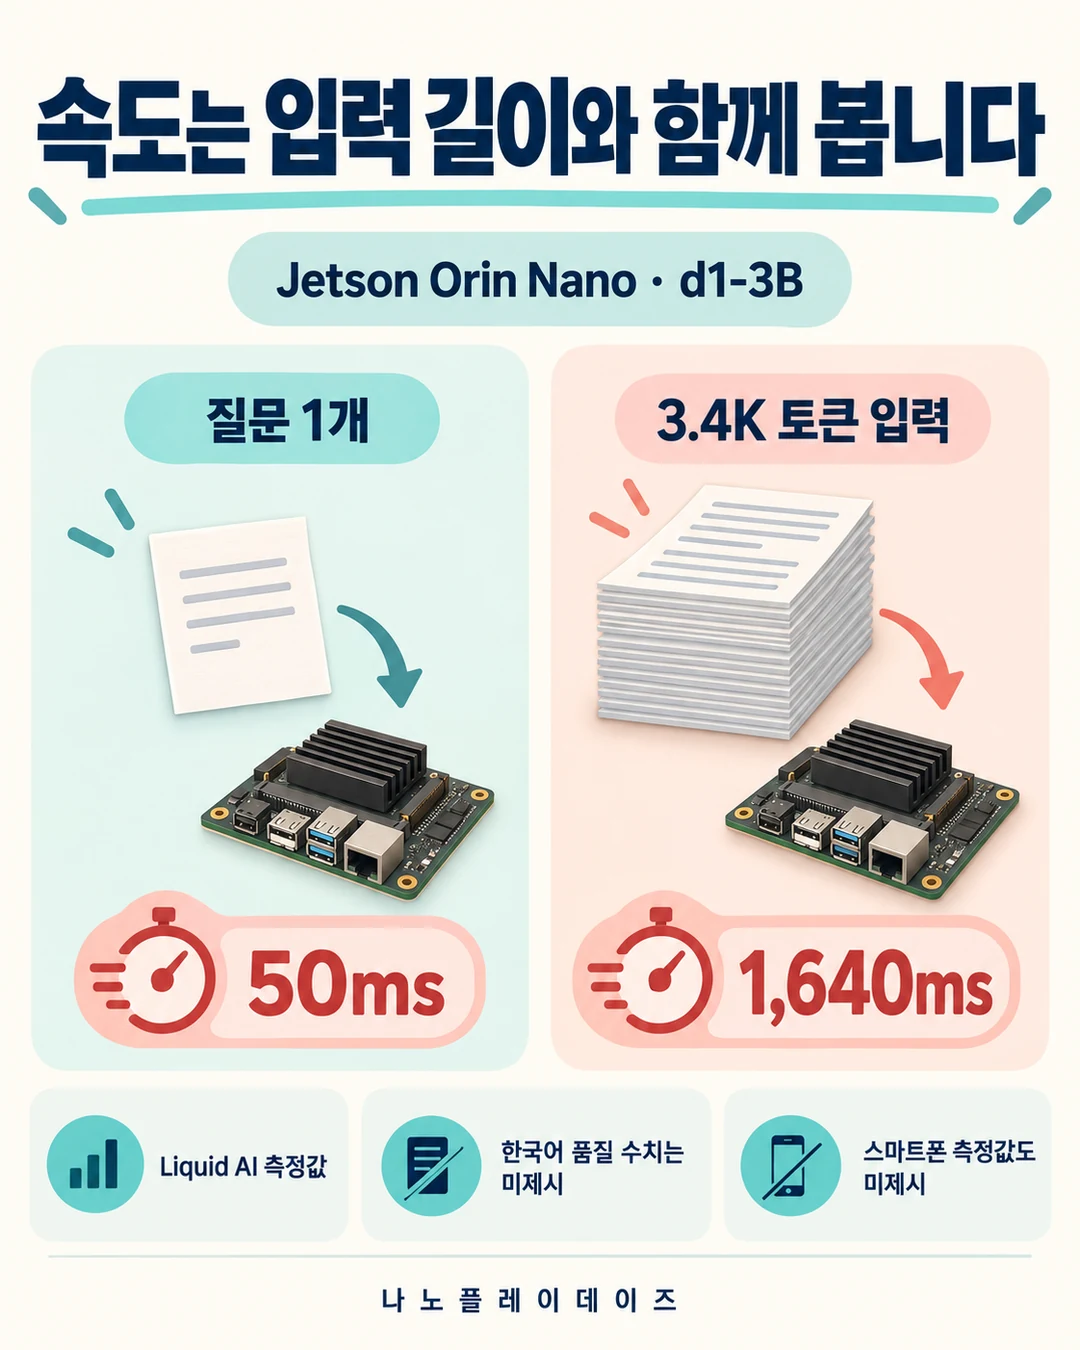
| Jetson Orin Nano | 50ms | 73ms | 1,640ms | 202ms | 초당 38건 |
| NVIDIA RTX 4090 | 8ms | 21ms | 102ms | 17ms | 초당 475건 |
| AMD MI325X | 9ms | 14ms | 44ms | 18ms | 초당 1,106건 |
마지막 열은 상황 64개를 빈칸 채움 없이 한 번에 묶어 보냈을 때의 처리량입니다. 쌓인 문의를 한꺼번에 분류하는 일괄 작업이라면 지연 시간보다 이 열이 기준이 됩니다.
눈여겨볼 차이는 짧은 질문의 속도와 입력을 길게 읽을 때의 속도입니다. Orin Nano의 한 질문은 50ms이지만 3.4K 토큰 입력은 1,640ms로 보고됩니다. 촬영된 자료나 긴 고객 기록을 처리하려는 개발자는 ‘16ms’ 같은 대표 수치보다 자기 입력 길이와 사진 크기에 대응하는 열을 먼저 볼 수 있습니다. (기기별 측정표)
같은 상황에 질문을 더할 때는 입력을 다시 읽는 비용을 줄일 여지가 있습니다. AGX Thor에서는 질문 1개 16ms에서 3개 20ms로 늘었다고 보고하지만, 다른 기기의 증가 폭은 표처럼 다릅니다. omni의 속도 값과 일반 스마트폰에서의 측정값은 이번 발표에 없습니다. 휴대전화에서 쓸 계획이라면 실제 장치에 자신의 입력을 넣어 시간을 재 볼 수 있습니다. (속도 범위)
제공·이용 조건: 로컬 실행은 어떻게 안내합니까?
회사는 두 모델을 Hugging Face에서 내려받을 수 있는 공개 가중치로 소개합니다. 제공 위치는 d1-3B와 d1-omni-600M 모델 저장소입니다. 한국에 대한 별도 지역 제한은 공개 발표와 모델 카드에 없습니다. 내려받는 파일은 safetensors 형식이며, d1-3B는 3.12B 매개변수의 BF16 가중치여서, 매개변수당 2바이트로 계산하면 약 6.2GB입니다(카드 표기가 아닌 우리 계산). (공개·배포 안내 · d1-3B 모델 카드)
공개 글의 d1-3B 설치 명령은 다음과 같습니다. Transformers는 모델 로딩과 실행을 연결하는 Python 라이브러리이며, PyTorch와 이미지 처리 라이브러리도 함께 설치하도록 안내합니다. (설치 예제)
pip install "transformers>=5.14" torch torchvision pillow
모델 로딩에는 AutoModel.from_pretrained("LiquidAI/d1-3B", trust_remote_code=True, ...)를 씁니다. trust_remote_code=True는 저장소가 제공하는 모델 코드를 불러오는 옵션입니다. 공개 예제는 CUDA가 가능하면 CUDA, 다음으로 Apple의 MPS, 그 외에는 CPU를 선택합니다. 데이터 형식은 CPU에서 float32, 다른 장치에서는 bfloat16으로 지정합니다. 이 선택 순서는 공개 예제에 따른 것으로, 장치별 호환성 목록은 따로 안내돼 있지 않습니다. (로딩 코드)
입력 문장과 질문 사전을 system_one에 전달하고, 복수 요청에는 system_one_batch를 사용하는 예제가 있습니다. omni는 발표 대신 모델 카드에 실행법이 있으며, 설치 명령에 오디오 파일을 읽는 soundfile이 더해지고 Transformers 5.15 이상을 요구합니다. 두 카드 모두 최소 RAM·VRAM과 지원 운영체제를 따로 적지 않았고, GGUF 같은 경량 변환 파일 언급도 없습니다. 기기를 새로 구매하기 전에 위 속도 표의 장치와 비슷한 환경에서 먼저 시험해 보세요. (실행 예제 · omni 모델 카드)
pip install "transformers>=5.15" torch torchvision pillow soundfile
비용·라이선스와 API 서비스는 어떻게 구분합니까?
공개 가중치를 로컬에서 실행하는 흐름은 Liquid AI API로 요청을 보내는 흐름과 나눠 봅니다. 로컬 작업에는 기기와 메모리, 전력 등 운영 비용이 생기며, 내려받아 쓰는 데 요청당 요금은 없습니다. 대신 두 모델 모두 Apache 같은 범용 라이선스가 아니라 Liquid AI의 LFM Open License v1.0을 따릅니다. (공개 가중치 안내 · d1-3B 저장소 · omni 저장소)
이 라이선스의 핵심 조건은 매출 기준입니다. 연 매출이 1,000만 달러 이상인 조직은 이 라이선스로 상업 이용을 할 수 없고, 비영리 단체의 비상업·연구 목적 이용은 예외입니다. 기준 미만의 개인·회사는 상업 서비스에도 쓸 수 있습니다. 재배포 조건은 라이선스 사본 동봉, 수정한 파일의 변경 표시, 저작권·출처 고지 유지입니다. 회사 규모가 기준에 가깝다면 법무 검토 뒤 도입하세요. (d1-3B 라이선스 원문)
10월 5일의 별도 API 발표는 서비스 모델 ID를 d1로 표기합니다. 입력 토큰만 과금하고 이미지는 32×32 픽셀 패치당 1.5토큰으로 계산한다고 안내합니다. 따라서 1024×1024 이미지는 1,536 입력 토큰에 해당합니다. 질문마다 자체 프롬프트로 텍스트와 전체 이미지를 포함해 청구한다는 조건도 있습니다. API 비교 시험에 사용한 단가는 입력 100만 토큰당 $0.04였으며, 이는 공개 로컬 모델의 이용료와 구분합니다. (API 과금·시험 방법)
API 발표는 Vercel과 OpenRouter에서도 텍스트만 제공하며 시각 지원은 예정이라고 설명합니다. 로컬 모델은 위의 입력 범위를 따르고, Vercel·OpenRouter 경로는 텍스트만 받습니다. 가격·성능을 비교할 때도 서비스 d1과 두 공개 모델을 나눠 볼 수 있습니다. (API 제공 경로)
어떤 작업부터 살펴볼 수 있습니까?
결과의 선택지가 정해진 고객 문의 분류, 사진 속 항목 선택, 우선순위 점수처럼 입력과 판단 기준을 함께 적을 수 있는 작업부터 살펴볼 수 있습니다. 공개 예제의 환불 여부·담당 부서·긴급도는 한 문장을 여러 목적에 재사용하는 구조를 보여 줍니다. 장문 설명까지 원하는 서비스는 결정 결과를 다음 처리 단계나 생성 모델에 전달하는 식으로 역할을 나눠 설계할 수 있습니다. (공개 사용 예제)
한국어 텍스트·이미지 작업은 한국어가 언어 목록에 있고 실행 예제와 속도 표가 있는 d1-3B부터 시험하는 순서가 맞습니다. omni는 한국어가 목록에 없고 오디오도 영어 대화로 학습했으니, 영어 음성 분류 같은 연구용 시험에 어울립니다. 관련 개념은 제브(Jev) 결정 모델의 입력·비용·한계에서도 함께 읽을 수 있습니다. 처음 시험할 때는 한국어 분류 정확도와 입력 길이별 지연, 장치 메모리를 기록해 볼 수 있습니다. 상업 서비스에 넣기 전에는 회사 매출이 라이선스 기준에 맞는지도 확인합니다.
반응 (2026년 10월 8일 확인 기준)
공개된 사용자 반응은 아직 확인되지 않았습니다.
참고한 자료
- Liquid AI: Multimodal open d1 decision models for the edge — 2026-10-07 발표. 모델 구조·평가·속도·실행 예제, 2026-10-08 확인.
- Liquid AI: Introducing d1, now with vision — 2026-10-05 발표. 별도 API의 질문 유형·입력 과금·제공 경로, 2026-10-08 확인.
- d1-3B 모델 카드 · d1-omni-600M 모델 카드 — 매개변수·언어 목록·입력 제약·설치 버전·Decision Index 개별 점수, 2026-10-08 확인.
- LFM Open License v1.0 — 상업 이용 매출 기준과 재배포 조건, 2026-10-08 확인.