
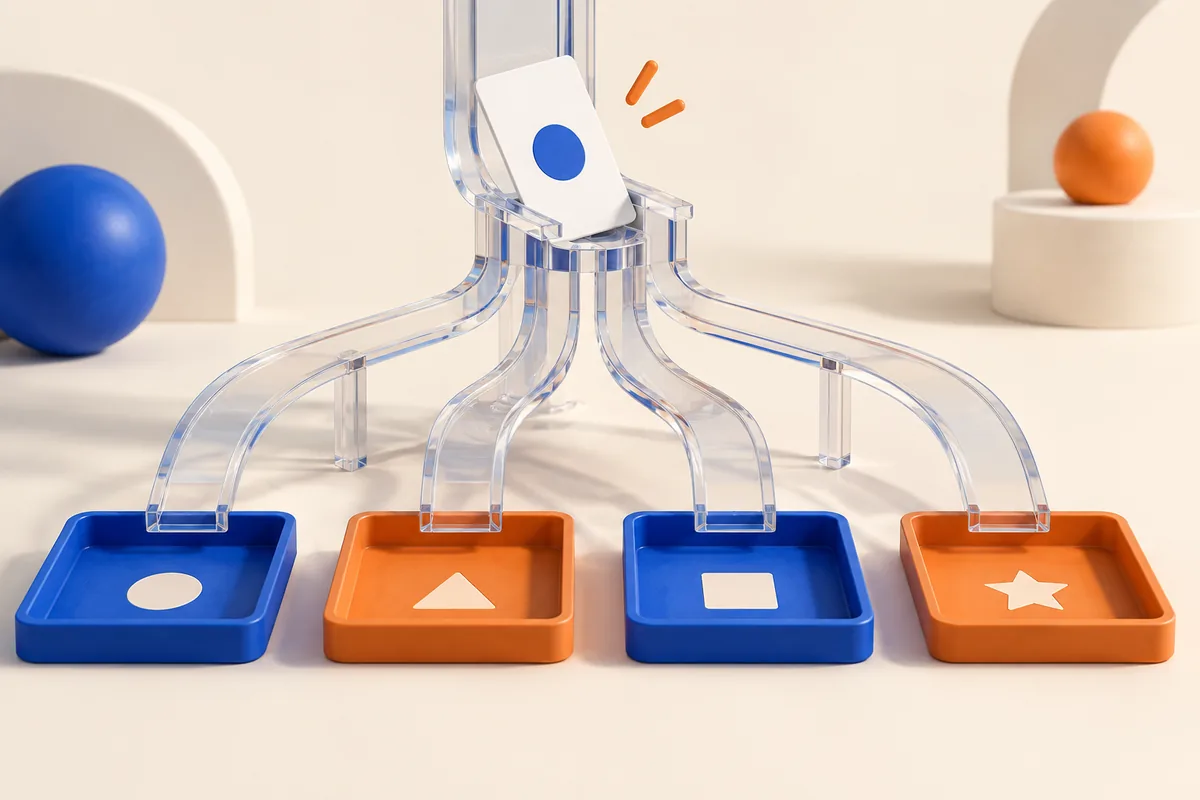
고객 문의가 들어오면 긴 답장보다 먼저 정할 게 있습니다. 이 문의를 어느 팀이 읽어야 하나. 이 한 번의 선택을 위해 매번 글 쓰는 AI를 부를 필요가 있을까요?
TypeSafe AI가 9월 15일 내놓은 Jev(제브)는 이 질문에서 출발한 모델입니다. 문장을 쓰지 않고, 정해진 선택지와 확률만 프로그램에 돌려줍니다. 그 대신 빠르고 쌉니다. (출시 발표)
출시 2주 동안 개발자들은 Jev로 포켓몬 게임을 끝까지 깼고, 비슷한 모델을 직접 만들어 공개했습니다. 반면 공개 벤치마크를 내지 않아 "마케팅 아니냐"는 의심도 따라붙었습니다.
답변 대신 무엇을 돌려주나
문의에 "결제·계정·기술·기타 중 어디로 보낼까?"라고 물으면 Jev는 한 항목을 고르고 항목별 확률을 붙입니다. 질문 방식은 세 가지입니다. (공식 소개)
| 질문 방식 | 돌려주는 것 | 어울리는 일 |
|---|---|---|
| Choice | 목록 중 한 항목과 항목별 확률 | 문의 담당 팀 고르기 |
| Score | 미리 정한 기준에 따른 점수 | 문서를 관련성 순으로 줄 세우기 |
| Noul | 문장이 맞을 확률(0~1) | 추가 검토가 필요한 문구 찾기 |
한 요청에 질문 여러 개를 넣으면 각 질문을 동시에, 서로 독립적으로 판단합니다. 여러 단계를 거치는 추론은 질문을 잘게 나누고 결과를 코드에서 이어 붙이는 식으로 만듭니다.
빠르다는 말, 실제로 재 보니 (9월 28일 기준)
TypeSafe는 응답 시간이 70~500밀리초로, 같은 수준의 판단을 생성형 모델에 맡길 때보다 40~200배 빠르다고 발표했습니다. 다만 공개 벤치마크 점수는 발표하지 않았습니다.
출시 뒤 개발자들이 직접 잰 결과가 나왔습니다.
- 문서 분류: DocJev 실험에서 문서 40개를 분류하게 했더니 Jev와 GPT-5.6 Luna 모두 40개를 맞혔습니다. 걸린 시간(중앙값)은 Jev 138.6ms, Luna 794.3ms로 약 5.7배 차이였습니다. 여러 문서를 묶은 파일을 정확히 나누는 시험에서는 Jev가 8묶음 중 7개, Luna가 8개를 맞혔습니다. 제작자가 직접 고른 작은 표본입니다.
- 브라우저 조작: Browser Use의 구현은 Jev가 누를 버튼과 동작을 고르고, 입력란에 글을 써야 할 때만 작은 생성 모델을 부릅니다. 구글 항공권 검색에서 취리히-런던 노선을 찾는 데 7.1초가 걸렸다고 공개했습니다.
2주 동안 나온 반응 (9월 28일 기준)
출시 토론은 기대와 의심이 함께였습니다. Hacker News 출시 토론은 1,900점을 넘고 댓글이 500개를 넘었습니다.
- 쓰임새: 대량 분류, 라우팅, 다른 AI의 답을 검증하는 용도로 쓰겠다는 댓글이 많았습니다.
- 의심: 공개 벤치마크를 내지 않은 점을 두고 "점수가 좋았으면 공개했을 것"이라는 비판이 나왔습니다.
- 대안: 분류기를 직접 학습시키면 되지 않느냐, 모델 가중치를 공개하면 써보겠다는 의견도 있었습니다.
그 뒤 2주는 놀이터가 됐습니다.
- 포켓몬 완주: Jev가 포켓몬 레드를 명예의 전당까지 깬 기록이 올라왔습니다. 37시간 40분 동안 1만 6,150번 결정했고 입력 토큰은 약 3,920만 개였습니다. 가격표대로 계산하면 약 1.65달러입니다. (Hacker News, 270점대)
- 25줄로 흉내 내기: 로컬 언어 모델이 다음에 쓸 단어의 확률을 꺼내 선택지별 확률로 바꾸면 Jev와 비슷한 판단을 흉내 낼 수 있다는 파이썬 25줄 예제가 690점을 받았습니다. (Hacker News)
- 오픈소스 복제판: 알리바바의 Qwen 모델을 바탕으로 한 Kev는 자체 평가에서 가장 큰 모델이 Jev와 1점 안쪽 차이를 냈다고 밝혔습니다. 제작자도 학습 데이터가 달라 공정한 비교는 아니라고 적었습니다. (Hacker News, 460점대) 내 컴퓨터에서 이런 모델을 돌리는 Ollaya도 나왔습니다.
- 엉뚱한 개조: 문장을 못 쓰는 Jev를 억지로 챗봇으로 만든 실험도 있었습니다. 제작자 스스로 "형편없는" 챗봇이라고 소개했습니다.
- 경쟁 전망: OpenAI가 비슷한 기능을 금방 따라 낼 수 있다는 분석 글도 300점을 넘기며 토론이 이어졌습니다.
국내에서는 GeekNews에 직접 써본 후기가 올라왔습니다. 글쓴이는 비용이 가장 인상적이었다며 "이 정도 판단이라면 반복해서 넣어볼 수 있겠다"고 적었고, 댓글에서는 LangGraph 같은 흐름의 분기(라우팅)에 붙이기 좋겠다는 의견이 나왔습니다. 한국어 정확도를 따로 잰 후기는 아직 찾기 어렵습니다.
한국어 업무에 넣는다면
가격은 입력 100만 토큰당 $0.042이고 출력은 무료입니다. 질문과 선택지를 합쳐 1,000토큰짜리 요청을 1만 건 보내면 $0.42입니다. 아직 사전 신청을 받는 early access 단계입니다. (모델 문서)
TypeSafe는 영어에서 정확도가 가장 높고, 한국어 같은 다른 언어는 자기 데이터로 먼저 시험해 보라고 안내합니다. 입력은 텍스트만 받습니다.
이미 사람이 처리한 한국어 문의나 문서가 쌓여 있다면 좋은 시험 재료가 됩니다. 같은 자료를 Jev와 지금 방식에 맡기고 맞힌 비율, 잘못 보낸 건수, 사람이 다시 읽은 건수, 처리 시간을 나란히 놓으면 속도 이점이 실제로 남는지 보입니다. 규칙 몇 줄로 정확히 나뉘는 일이라면 규칙이 여전히 가장 싸고 빠릅니다.
참고한 자료
- TypeSafe AI: Jev 출시 발표 (2026-09-15)
- TypeSafe AI: 질문 방식 소개 · 모델·가격·언어 지원
- DocJev: 문서 분류·분할 실험 · Browser Use: Jev 브라우저 에이전트
- Hacker News 출시 토론
- Jev 포켓몬 완주 기록 · 25줄 파이썬 예제 · Kev · Ollaya · Jev 챗봇 개조 · OpenAI 경쟁 분석
- GeekNews: Jev 사용 후기
가격, 문서, 사례, 반응은 2026년 9월 28일에 확인했습니다.