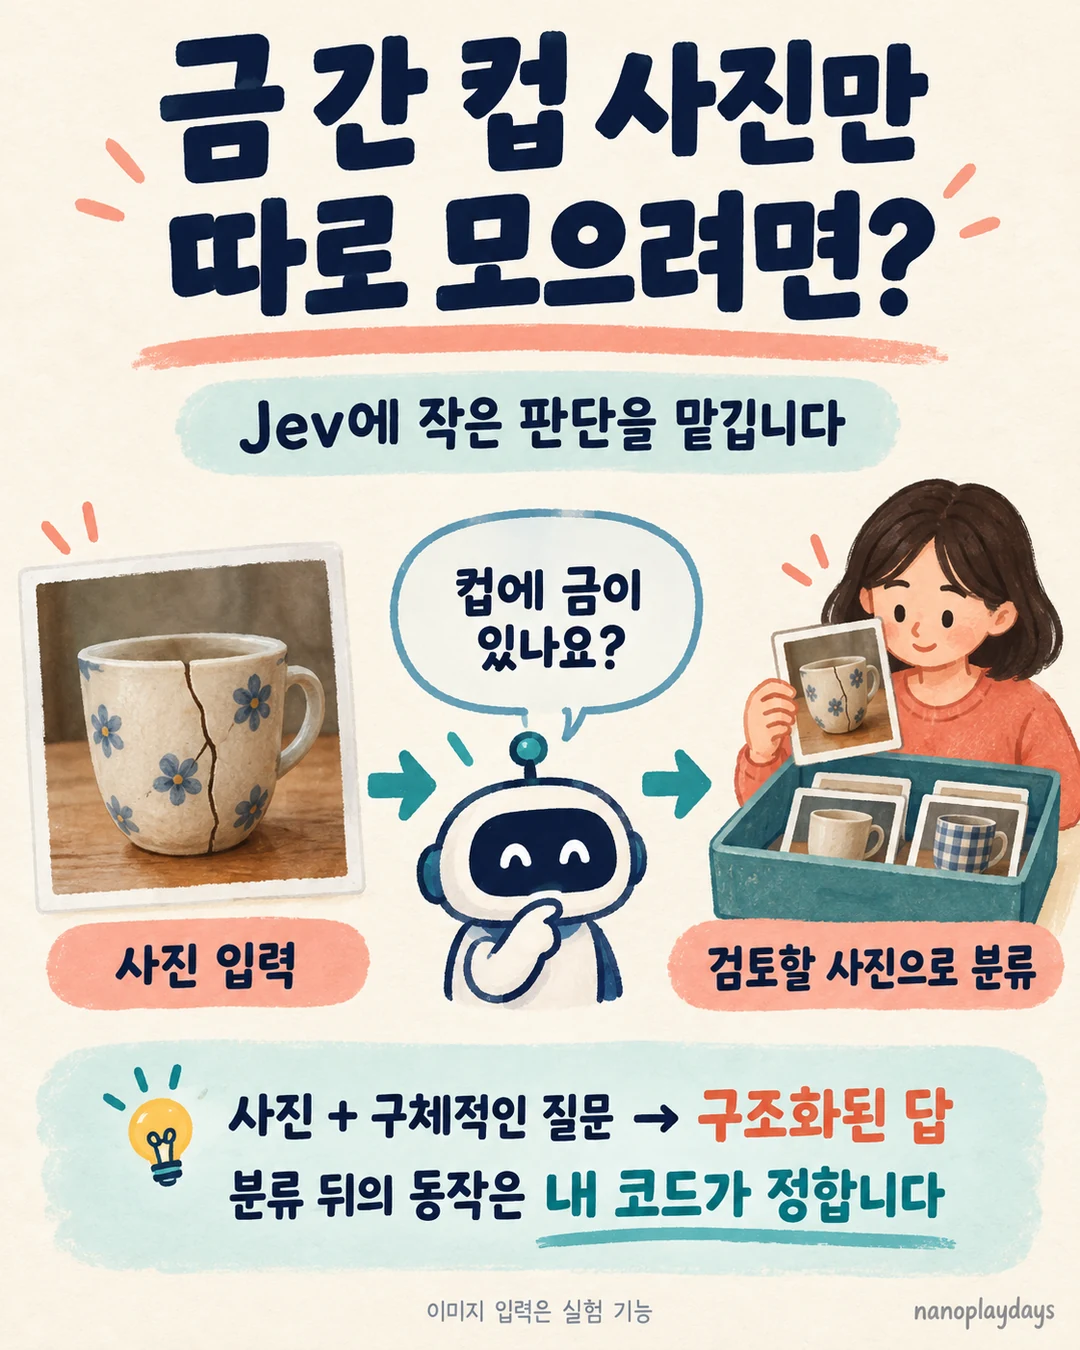
컵 사진 수백 장에서 금이 간 사진만 검토함으로 보내고 싶다면, 사진마다 긴 설명문을 받을 필요는 없습니다. “컵에 금이 있나요?”라는 질문의 답을 받아 다음 동작으로 연결하면 됩니다. TypeSafe AI의 Jev는 이런 작은 판단을 소프트웨어에 붙이도록 만든 모델입니다.
TypeSafe는 2026년 10월 14일 Jev 1.14.0과 함께 이미지 입력, 물체의 위치를 돌려주는 box, 긴 문맥 설정을 발표했습니다. 사진을 조건에 따라 분류하거나 이미지 속 대상을 찾아 후속 도구에 넘기는 구상을 해 볼 수 있습니다. 다만 제작사는 이 기능들을 실험 단계로 공개했고, 아직 운영 환경에 권할 품질에는 이르지 않았다고 설명합니다.
아래는 10월 16일 확인한 공식 발표와 API 문서를 기준으로, 무엇을 맡길 수 있고 어떤 조건부터 확인해야 하는지 정리한 내용입니다.
Jev가 맡는 것은 작고 구체적인 판단입니다
TypeSafe가 부르는 System One 모델은 입력 자료에 대해 미리 정한 형태로 판단을 돌려주는 모델입니다. 자료는 state, 그 자료에 묻는 질문은 questions에 넣습니다. 응답을 받은 프로그램은 조건에 맞춰 분기하거나, 정렬하거나, 다음 작업으로 넘깁니다. 그래서 smart-if, 즉 내용까지 읽고 판단하는 조건문에 비유할 수 있습니다.
공식 소개 문서는 다음 세 가지 질문 형태를 설명합니다.
| 질문 형태 | 묻는 일 | 컵 사진 분류에 적용하면 |
|---|---|---|
noul |
어떤 문장이 참일 가능성을 0~1 값으로 받기 | “사진 속 컵에 금이 있나요?” |
choice |
정해 둔 선택지 중 하나 고르기 | “컵의 손잡이 상태는 정상·파손·판별 어려움 중 무엇인가요?” |
score |
정해 둔 기준으로 점수 매기기 | “상품 사진으로 쓰기 좋은 선명도인가요?” |
선택지나 점수의 기준은 개발자가 작성합니다. 예컨대 손잡이 파손 여부와 사진의 선명도를 각각 물어보고, 두 결과를 어떻게 결합할지는 코드에서 정할 수 있습니다. 여러 질문은 같은 자료에 대해 병렬로 평가되며, 한 질문의 답을 다른 질문이 이어받아 판단하는 구조는 아닙니다.
처음에는 “이 상품을 팔아도 될까요?”처럼 넓은 질문보다 “컵의 손잡이가 끊어져 있나요?”처럼 눈으로 확인할 조건 하나를 묻는 편이 적합합니다. 판매 가능 여부에는 파손 정도, 안전 기준, 판매 정책 등 서로 다른 판단이 들어가기 때문입니다. 실제 불량 검수에 도입하려면 정상·파손·흐릿한 사진을 나눠 오분류를 먼저 확인해야 합니다.
이미지 입력은 어떻게 연결하나요
이미지 문서에 따르면 Jev 1.13과 1.14 모두 이미지 입력을 지원합니다. 이미지는 기존 1.13에도 잠재돼 있던 기능을 이번에 열어 준 것이고, 아래에서 설명할 새 box 질문은 1.14가 필요합니다. 모델 표에는 입력이 아직 Text로만 적혀 있으므로, 이미지 지원은 별도 이미지 문서와 함께 확인해야 합니다.
이미지 기능은 기본적으로 꺼져 있습니다. 이미지가 들어가는 요청마다 다음 헤더를 붙입니다.
TypeSafe-Danger-Zone-Images: true
HTTP API에서는 최상위 assets에 사진을 등록하고, 그 참조 문자열을 state, 질문의 instructions, 선택 기준인 criteria에 넣습니다. 하나의 기준 사진과 닮았는지 비교하거나, 선택지마다 예시 사진을 붙이는 구성도 가능합니다. 같은 참조 문자열을 여러 곳에서 쓰면 모델이 읽는 이미지도 그만큼 늘어나므로, 여러 질문이 함께 볼 사진은 state에 한 번 두는 방식부터 검토할 만합니다.
다음은 공식 multipart 요청 예시를 컵 사진에 맞춰 바꾼 호출 형태입니다. Bash 계열 셸에서 API 키를 TYPESAFE_API_KEY 환경변수에 넣고, 조건에 맞게 준비한 cup.jpg를 현재 폴더에 두는 경우입니다. 실행하면 API 사용료가 발생할 수 있습니다.
curl https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "TypeSafe-Danger-Zone-Images: true" \
  -F 'request={
    "model": "jev-1.14.0",
    "state": {"photo": "8ebef567-cup-photo"},
    "assets": {
      "8ebef567-cup-photo": {"type": "image", "part": "cup-file"}
    },
    "questions": {
      "has_crack": {
        "type": "noul",
        "instructions": "Is there a visible crack in the cup in `photo`?"
      }
    }
  };type=application/json' \
  -F 'cup-file=@cup.jpg;type=image/jpeg'
응답의 has_crack 값을 보고 검토함으로 보낼지 정하는 부분은 자신의 프로그램에서 구현합니다. 이 글에서는 실제 API 호출이나 컵 사진의 분류 정확도를 시험하지 않았습니다.
사진 준비에도 조건이 있습니다. 현재 문서는 정지 PNG·JPEG, 가로와 세로 각각 280~1568픽셀, 파일당 16MiB 이하를 요구합니다. 범위를 벗어난 사진을 서버가 자동으로 줄여 주지 않으므로 휴대폰 원본은 미리 축소해야 합니다. 반대로 한 변이 280픽셀보다 작다면 확대하거나 여백을 넣어 최소 크기를 맞춥니다. HEIC·WebP는 PNG나 JPEG로 변환하고, 회전 정보에만 기대지 말고 실제 픽셀 방향을 바로잡습니다. 요청 본문은 32MiB 이하이며 여러 이미지·참조 확장에도 별도 합계 제한이 있으므로 대량 요청 전에는 문서의 전체 한도를 확인해야 합니다.
물체의 위치를 찾는 box에는 ‘없음’ 응답이 없습니다
새 box 질문은 이미지 속 대상 하나를 감싸는 사각형을 돌려줍니다. 예를 들어 “사진 속 컵”의 위·아래·왼쪽·오른쪽 경계를 0~1 비율로 받습니다. 이미지의 가로·세로 크기를 곱하면 실제 픽셀 좌표로 바꿀 수 있습니다. 상품 사진에서 컵 영역을 잘라 내는 도구와 연결하는 식입니다.
Box 문서의 중요한 제한은 대상이 없어도 사각형이 반환된다는 점입니다. 컵이 없는 사진에 “컵의 위치”를 물어도 좌표가 나오므로, 좌표를 받았다는 사실만으로 컵이 있다고 판단하면 안 됩니다. 공식 문서는 같은 요청에 “컵이 있나요?”라는 noul 질문을 함께 넣고, 그 결과가 낮으면 사각형을 사용하지 않는 방법을 안내합니다.
Box 응답의 confidence는 0~1 값이며, 공식 권장 임계값은 아직 없습니다. 자신의 사진으로 기준을 정하고, 낮은 값에서는 박스에 여백을 더하거나 더 나은 이미지로 다시 묻는 방법을 문서가 제안합니다.
질문 하나가 돌려주는 사각형도 하나입니다. 컵 여러 개를 한 번에 모두 탐지하는 용도로 이해하면 맞지 않습니다. 대상을 구체적으로 지정하거나 이미지를 나눠 다시 묻는 설계가 필요합니다. 영상도 직접 받지 않으므로 필요한 장면을 정지 이미지로 추출하는 과정이 먼저입니다.
1.14 사용 조건과 262k 문맥 설정
현재 모델 문서에서 jev-preview는 1.14.0, SDK 기본값인 jev-latest는 1.13.0을 가리킵니다. 1.14의 Box를 시험하려면 jev-preview 또는 jev-1.14.0을 명시해야 합니다. 발표문은 약 일주일 뒤 jev-latest를 1.14로 옮길 계획을 밝혔지만, 이 글의 확인 시점에는 아직 1.13으로 안내돼 있습니다.
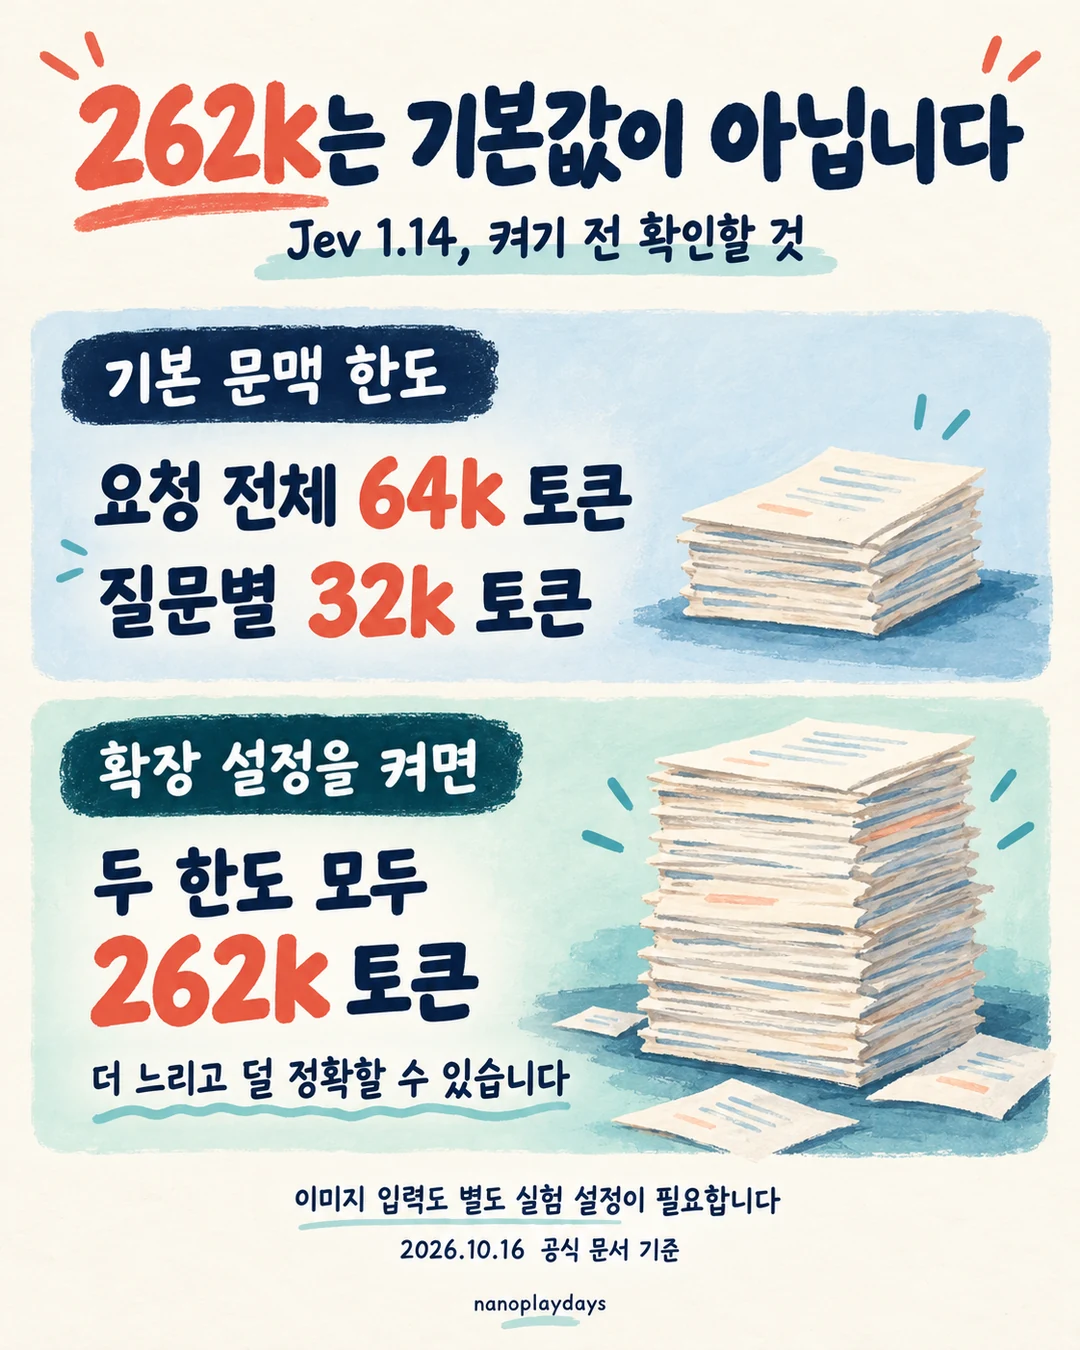
기본 문맥 한도와 확장 한도도 다릅니다. 여기서 문맥은 모델이 한 번에 읽는 텍스트와 이미지 등 입력을 토큰 단위로 센 양입니다.
| 설정 | 요청 전체 | 질문 하나와 자료를 합친 한도 |
|---|---|---|
| 기본 | 64k 토큰 | 32k 토큰 |
| 긴 문맥 헤더 사용 | 262k 토큰 | 262k 토큰 |
확장하려면 요청마다 TypeSafe-Danger-Zone-Long-Context: true를 붙입니다. 1.13과 1.14 모두 이 설정을 지원합니다. TypeSafe는 긴 문맥이 기본 범위 안에서 쓰는 것보다 느리고 덜 정확하다고 명시합니다. 262k 지원을 정확도 향상이나 기본 처리량으로 읽기보다, 정말 긴 자료가 필요할 때 선택하는 설정으로 이해하는 편이 좋습니다.
이미지와 긴 문맥은 서로 다른 헤더입니다. 긴 문맥을 켰다고 이미지 입력까지 켜지는 것은 아닙니다.
비용과 한국어 이용에서 확인할 점
공식 가격은 두 버전 모두 입력 100만 토큰당 미화 0.042달러, 출력 토큰은 무료입니다. 예를 들어 질문·기준·이미지를 모두 포함한 총 입력이 요청당 1만 토큰인 작업을 100번 보낸다면 총 100만 입력 토큰이므로 표시 단가로 0.042달러입니다. 이는 토큰 수를 가정한 단순 계산이며 세금·환율·결제 조건은 포함하지 않았습니다.
이미지도 입력 토큰에 합산됩니다. 사진 한 장이 몇 토큰인지에 대한 추정 지침은 아직 예고 상태여서, 이 가격을 곧바로 **“사진 100장에 얼마”**로 계산하려면 실제 이미지 토큰 수가 필요합니다. 실제 응답의 usage.input_tokens로 작업량을 확인해야 합니다. 긴 문맥 설정의 토큰당 단가는 같지만, 읽는 양이 늘면 총비용도 늘어납니다.
한국어는 처리 대상에 포함되지만, 모델 문서는 영어에서 정확도가 가장 좋고 한국어를 포함한 CJK 언어가 같은 수준은 아니라고 설명합니다. 1.14의 다국어 개선은 제작사의 기대이며, 이번 조사에서 한국어 독립 평가 수치는 확인하지 못했습니다. 한국어 기준문을 쓸 때는 자신의 사진과 표현으로 결과를 대조해야 합니다.
공개 API와 개발자 콘솔은 확인했으나 한국 거주 계정의 가입·결제 지원은 공식 자료와 실제 계정에서 확인하지 못했습니다. Python·JavaScript SDK가 공개돼 있다는 사실과 모델 가중치의 공개 여부도 구분해야 합니다. 이번에 모델 가중치나 그 공개 라이선스는 확인하지 못했습니다.
사진은 외부 API로 전송됩니다. 데이터 처리 안내는 고객 요청·응답으로 학습하지 않는다는 설명과 기업용 무보존 옵션을 구분합니다. 학습에 쓰지 않는다는 문구를 모든 계정의 무보존 보장으로 해석하지 말고, 얼굴·주소·기밀이 있는 사진은 자신에게 적용되는 처리 조건부터 확인해야 합니다.
반응과 도입 판단 (2026년 10월 16일 기준)
이번 조사에서는 1.14의 이미지 판단을 독립적으로 재현한 실사용 후기나 한국어 비교 평가를 확인하지 못했습니다. TypeSafe는 자체 평가도 자사 모델에 편향됐을 수 있으니 자신의 작업으로 평가하라고 당부합니다. “빠르고 안전하다”는 소개만으로 영상 편집 전체의 속도나 불량 검수의 정확도가 검증되지는 않습니다.
지금 살펴볼 만한 곳은 실패해도 사람이 확인할 수 있는 사진 분류나 이미지 자르기 시제품입니다. 자신이 기준을 정할 수 있는 질문 하나로 시작하고, 대상이 없는 사진·흐린 사진·정상 사진을 함께 넣어 보는 편이 구체적입니다. 잘못된 답이 자동 삭제·공개·금전 처리로 곧장 이어지는 연결은 별도의 검증이 필요합니다. 정해진 형태의 답이 나오는 것과 그 판단이 맞는 것은 따로 확인해야 합니다.
이미지를 만드는 작업이 궁금하다면 FLUX 3 Image Klein의 좌표 배치 안내도 함께 읽을 수 있습니다. Jev의 Box는 사진 속 대상의 위치를 읽고, FLUX의 좌표 입력은 만들 이미지의 배치를 유도합니다.
참고한 자료
모두 2026년 10월 16일 확인했습니다.
- TypeSafe: Jev 1.14 발표 — 발표일, 실험 기능, 미리보기와 버전 전환 계획
- Jev 소개 — 구조화된 판단과 질문 분해
- 이미지 입력 문서 — 입력 위치, 헤더, 파일·해상도 제한과 과금
- Box 문서 — 좌표 형식, 단일 대상과 대상 부재 시 동작
- 모델·가격 문서 — 별칭, 문맥 한도, 가격, 언어 지원
- 데이터 처리·계약 안내 — 학습 정책과 기업용 무보존 안내