LiteRT로 기기 안에서 AI 모델을 돌리는 개발자는 기존 TFLite GPU delegate의 기능 업데이트 종료에 맞춰 새 가속 경로를 살펴볼 수 있습니다. Google은 2026년 10월 8일 GPU 추론 엔진 ML Drift를 Apache 2.0 오픈소스로 공개했습니다. 기존 모델의 역호환을 표방하면서 모바일·웹·데스크톱의 GPU API 차이를 묶고, 생성형 모델에 맞는 실행 최적화를 추가합니다. (공식 발표)
지역별 클라우드 서비스보다 앱에 넣는 런타임에 가까운 발표입니다. EmbeddingGemma 2의 기기 내 검색처럼 모델을 배포할 때 그 아래의 실행 엔진을 고르는 문제와 이어집니다. 이번 공개에 대한 사용자 반응은 아직 확인되지 않았습니다. (모델 배포 안내)
한눈에 보기
| 궁금한 점 | 이번 발표의 핵심 |
|---|---|
| ML Drift는 무엇입니까? | 기기 내 AI 모델의 GPU 연산을 실행하는 공통 엔진입니다. |
| LiteRT와 어떤 관계입니까? | LiteRT의 핵심 GPU 가속 엔진이며 독립 C++ 라이브러리로도 씁니다. |
| 어떤 API를 다룹니까? | OpenGL ES·OpenCL·Metal·WebGPU의 차이를 추상화합니다. |
| 기존 모델을 다시 만듭니까? | Google은 기존 모델의 완전한 역호환을 표방합니다. |
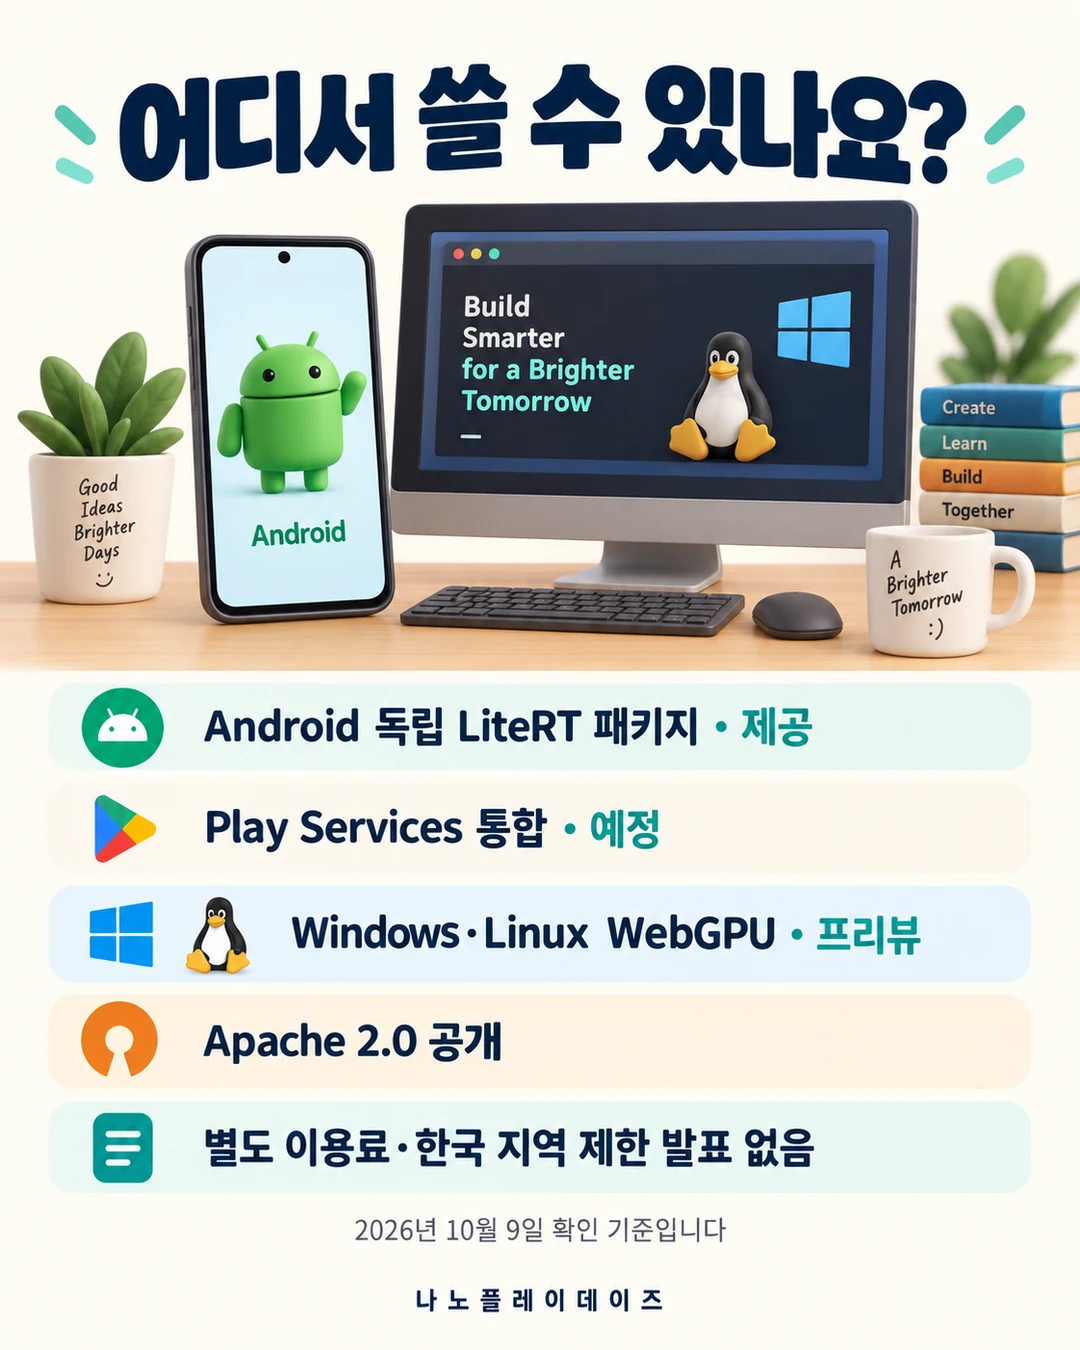
| Android에서 지금 씁니까? | 독립 LiteRT 패키지는 현재 제공하며 Play Services 통합은 예정입니다. |
| 데스크톱 상태는 어떻습니까? | Windows·Linux의 WebGPU 경로는 프리뷰이며 macOS의 Metal 경로도 설명합니다. |
| 무엇이 추가됩니까? | 5D 텐서, 커스텀 연산자 등록, LLM 단계별 커널·메모리 배치 최적화입니다. |
| 비용·한국 조건은 무엇입니까? | Apache 2.0 공개이며 별도 이용료와 한국 지역 제한은 발표되지 않았습니다. |
제공 상태와 기능은 Google 발표·개발자 문서를 따릅니다. 아래 지연·메모리 개선은 Google이 보고한 제품 사례와 자체 시험값입니다. 서로 다른 모델과 작업의 수치이며 독립 측정이나 한국 판매 기기의 공통 속도와 구분합니다. (발표 · GPU 개발자 문서)
GPU delegate에서 왜 새 엔진으로 옮깁니까?
쉽게 말하면, 모델 연산을 GPU에 맡기는 구현을 여러 기기에 공통으로 적용하려는 변화입니다. LiteRT는 학습된 모델을 기기에서 실행하는 런타임이고, 기존 delegate는 그 연산 일부를 GPU에 넘기는 역할을 했습니다. 기기마다 칩·드라이버·API가 다른 데다, 최근에는 영상 효과뿐 아니라 큰 생성형 모델까지 같은 기기에서 실행해 메모리와 연산 병목이 커졌다는 것이 Google의 설명입니다. (새 엔진의 배경)
ML Drift는 텐서 가상화로 모델의 논리적인 데이터 모양과 GPU의 실제 텍스처·버퍼 배치를 분리합니다. 텐서는 수치 데이터를 여러 차원으로 담는 배열이고, 셰이더는 GPU에서 그 데이터를 계산하는 코드입니다. 초기화 단계에 공통 셰이더 템플릿의 좌표를 변환해, 각 API마다 별도 코드를 관리하는 부담을 줄이는 설계입니다. (텐서 가상화)
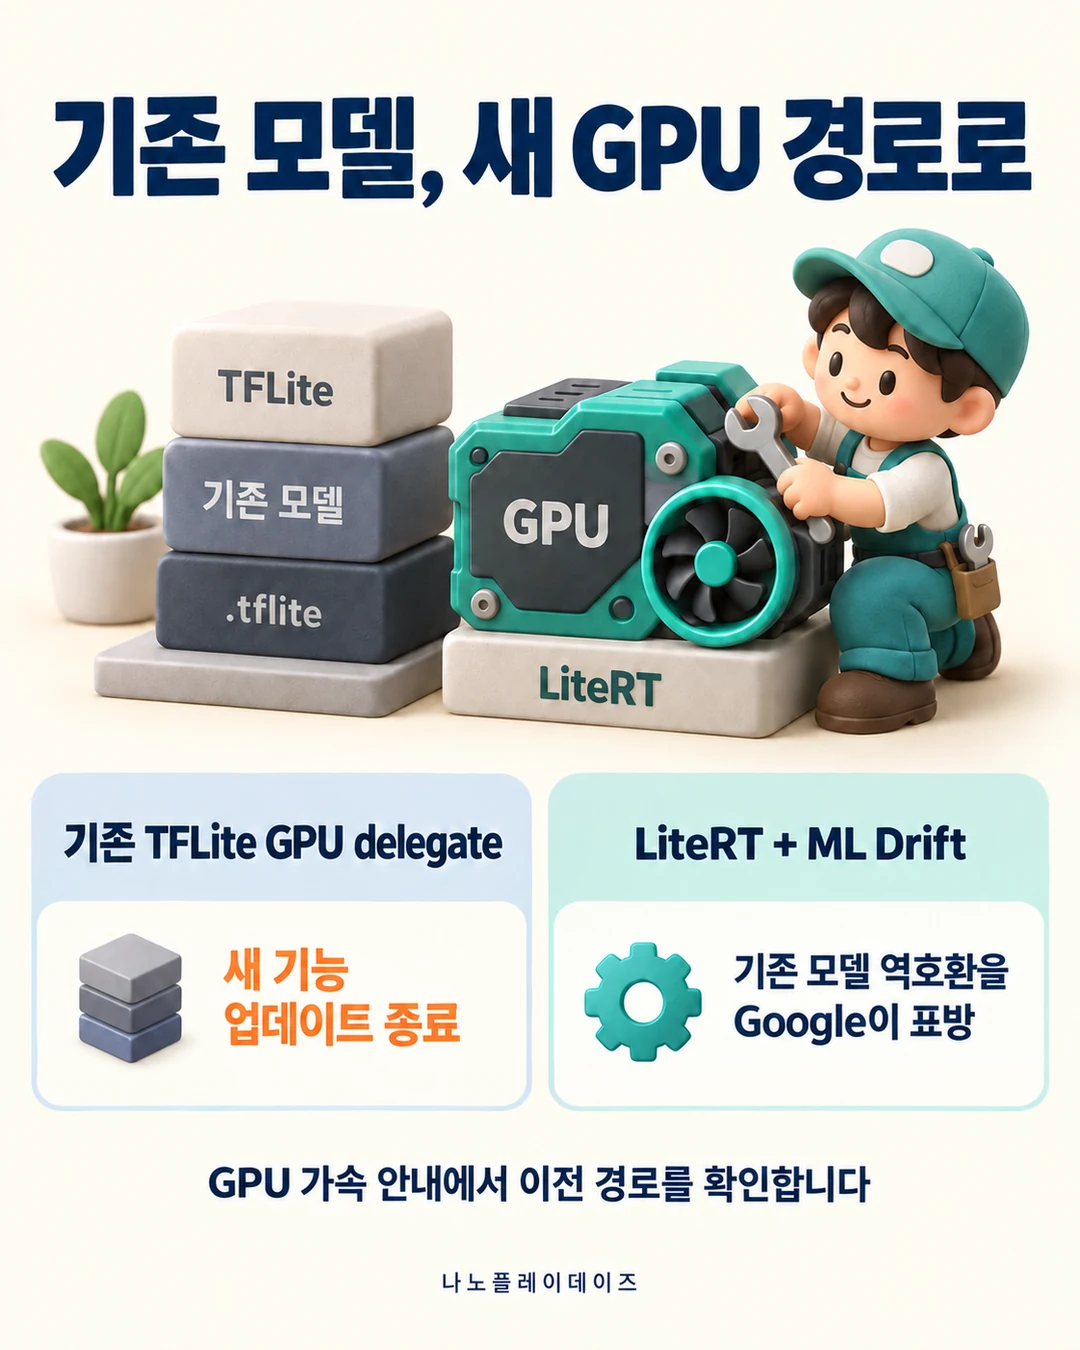
구형 TFLite GPU delegate는 앞으로 새 기능 업데이트를 받지 않습니다. Google은 기존 모델과의 역호환 및 기존 작업의 성능 유지·향상을 내세우며 LiteRT ML Drift 가속기로 이전하도록 안내합니다. 발표는 기존 앱을 즉시 중단시키는 날짜를 제시하지 않았습니다. 기존 모델을 유지하면서 새 기능과 최적화를 받을 실행 경로를 바꾸는 것이 이번 이전의 목적입니다. (이전 안내)
5D 텐서와 커스텀 연산자는 어디에 쓰입니까?
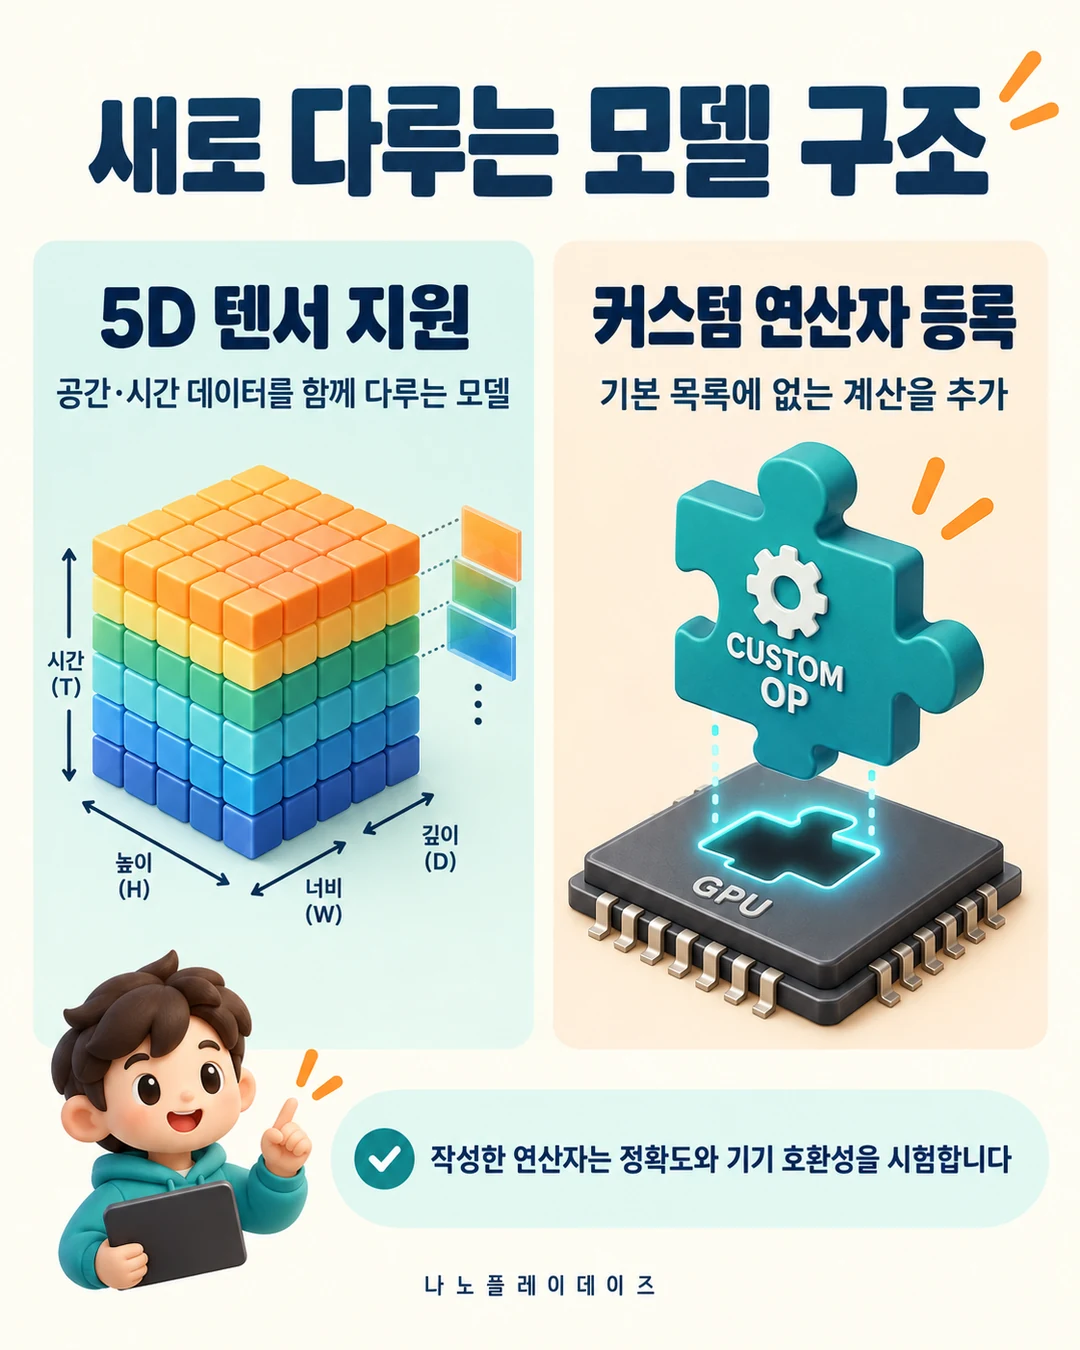
기존 delegate가 4차원 텐서에 고정돼 있던 제약을 풀고 5차원을 지원합니다. 공간·시간 정보를 함께 다루거나 3차원 합성곱을 쓰는 모델은 데이터 배치를 우회하는 작업을 줄일 수 있습니다. Google은 YOLO 11n, MobileViT v2, Swin Transformer v2 같은 모델 예시도 소개합니다. GPU에서 직접 처리할 수 있는 모델 구조가 더 넓어지는 변화입니다. (5D 지원 설명)
커스텀 연산자 등록 API는 기본 연산 목록에 없는 계산을 실행 그래프에 넣는 경로입니다. 저수준 셰이딩 언어에 접근할 수 있고, 코딩 에이전트가 셰이더 작성·등록·검증을 돕도록 SKILL.md 안내도 포함합니다. 특수한 모델 블록을 개발하는 팀은 독립 라이브러리와 이 API를 살펴보고, 작성한 연산자의 정확도와 기기 호환성을 시험할 수 있습니다. (커스텀 연산자)
LLM은 입력 처리와 답변 생성에서 무엇이 달라집니까?
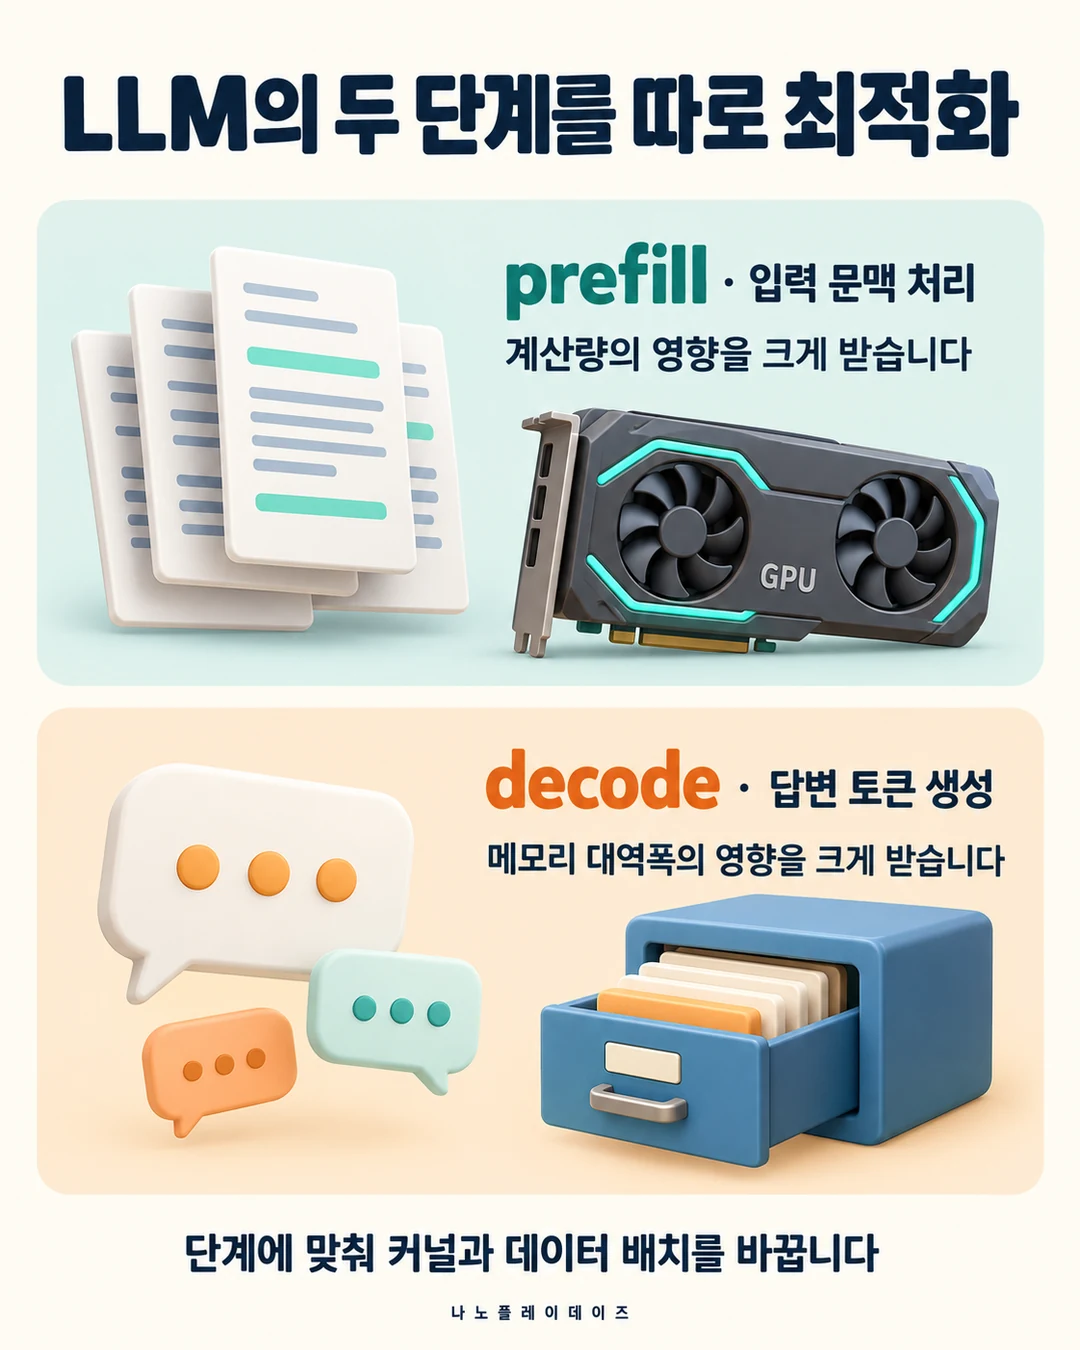
LLM의 prefill은 입력 문맥을 먼저 처리하는 단계이고, decode는 답변 토큰을 하나씩 생성하는 단계입니다. 앞 단계는 계산량, 뒤 단계는 메모리 대역폭의 영향을 크게 받습니다. ML Drift는 실행 단계에 따라 커널과 데이터 배치를 바꾸고, decode에서는 전용 KV cache 배치와 커널 내부 활성값 양자화로 메모리 왕복을 줄입니다. KV cache는 이미 계산한 문맥 정보를 재사용하는 저장 공간입니다. (단계별 최적화)
Google의 Gemma 시험은 모바일과 데스크톱에서 문맥 길이가 다릅니다. 처리량 그림도 prefill과 decode에 각각 다른 축을 쓰며, Gemma 4 E2B는 cross KV sharing을 지원하는 프레임워크에서 더 잘 동작한다는 주석이 붙습니다. 이런 조건을 함께 읽으면 입력 처리 속도와 답변 생성 속도를 섞어 비교하는 일을 줄일 수 있습니다. (시험 주석)
| 시험 | 입력·출력·문맥 조건 | 공통 설정 |
|---|---|---|
| 모바일 Gemma 그림 | prefill 512, decode 128, 문맥 640 | 4비트 가중치, 블록 크기 32, fp16 KV cache |
| 데스크톱 Gemma 표 | prefill 8192, decode 1024, 문맥 9216 | 4비트 가중치, 블록 크기 32, fp16 KV cache |
두 시험 모두 argmax sampling과 토큰마다 동기화하는 설정입니다. 발표는 다른 프레임워크 대비 메모리 오버헤드가 최대 12% 줄었다고 보고합니다. 메모리 오버헤드 감소율과 모델을 포함한 전체 메모리 사용량 감소율은 다른 지표입니다. (조건과 메모리 결과)
제품에서 보고한 속도 개선은 어느 정도입니까?
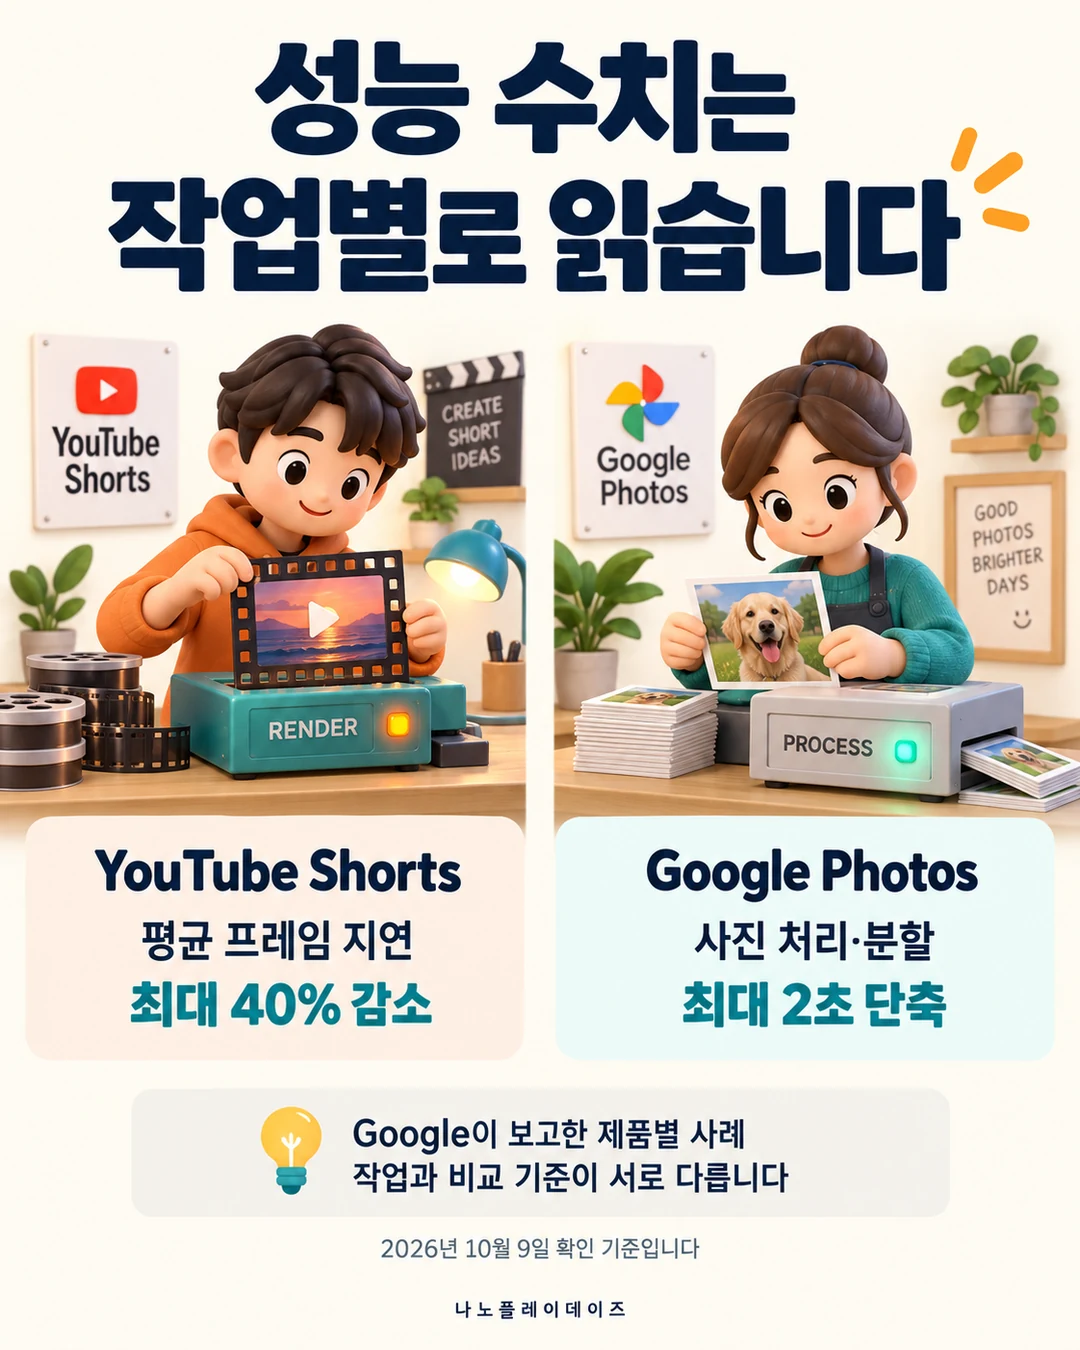
아래는 Google이 소개한 제품별 적용 사례입니다. 작업과 기준이 달라 각 개선율을 해당 기능의 결과로 읽습니다. 특히 최대 개선값은 전체 사용자의 평균 체감과 구분됩니다. (제품 사례)
| 제품·작업 | Google 발표값 | 비교 맥락 |
|---|---|---|
| YouTube Shorts 분할 기반 효과 | 평균 프레임 지연 최대 40% 감소 | Android·iOS에서 ML Drift로 이전한 사례입니다. |
| Google Photos 사진 처리·분할 | 최대 2초 단축 | 기존 GPU delegate와 비교한 사례이며 Unblur 시연을 포함합니다. |
| Adobe Lightroom·Photoshop 모바일 | 기기 내 성능 최대 30% 향상 | Select Subject·Select Sky·Adaptive Portrait 기능입니다. |
| Snapchat 얼굴·스타일 생성 렌즈 | 모델 지연 30% 개선 | Android GPU의 기기 내 추론 사례입니다. |
Chrome에서는 Gemini Nano를 쓰는 Prompt·Summarize·Writer 같은 Built-In AI API의 가속 기반으로 소개합니다. 발표 시연은 Cafe24의 Prompt API 태그 생성을 보여 줍니다. Meet와 AI Edge Gallery도 실제 적용 제품 목록에 들어가지만, 발표의 모든 제품에 같은 개선 수치가 붙은 것은 아닙니다. (Chrome과 적용 제품)
칩 최적화 협력사는 Arm·Intel·Qualcomm입니다. Arm의 Mali·Immortalis 커널과 캐시, Intel Xe3 그래픽의 WebGPU·XMX, Qualcomm Adreno의 OpenCL 연산과 메모리 대역폭을 각각 다룹니다. 앱 팀의 성능 판단에는 자기 모델과 대상 기기의 조합이 기준이 됩니다. (칩별 최적화)
제공·이용 조건: 앱에는 어떻게 붙입니까?
앱 개발자는 LiteRT GPU 가속 안내에서 시작합니다. Android Kotlin 문서는 핵심 litert와 GPU용 litert-gpu Maven 의존성을 함께 추가하도록 안내하며, 확인일의 예시는 두 패키지 모두 2.3.0입니다. CompiledModel 생성 시 GPU 가속을 지정하는 방식입니다. C++ 사용자는 GPU 가속기 사전 빌드 파일을 추가하거나 소스에서 빌드하는 경로를 따릅니다. (GPU 문서)
GPU·시스템 엔지니어는 ML Drift 저장소의 독립 C++ API로 GpuModel 연산 그래프와 커스텀 셰이더를 구성할 수 있습니다. 발표는 Android OpenCL과 Dawn을 통한 WebGPU 빠른 시작 경로를 제시합니다. Dawn은 Chromium의 WebGPU 구현이며, 웹용 경로를 브라우저 밖 네이티브 실행에도 활용하는 기반입니다. (시작 경로)
| 플랫폼·배포 경로 | 발표 시점의 상태 |
|---|---|
| Android 독립 LiteRT 패키지 | 현재 제공입니다. |
| Android LiteRT in Google Play Services | ML Drift 통합은 예정입니다. |
| iOS·Web | 이전 안내의 지원 플랫폼에 포함합니다. |
| macOS | 네이티브 Metal 경로를 설명합니다. |
| Windows·Linux | WebGPU 기반 데스크톱 프리뷰입니다. |
서울을 포함한 별도 지역 제한은 발표되지 않았습니다. 한국에서 쓰는 앱도 배포 경로와 기기의 GPU·드라이버·모델 호환성이 주요 확인 항목입니다. 지원 여부는 사용할 기기의 GPU·드라이버와 모델 조합으로 확인할 수 있습니다. (제공 상태)
비용·라이선스와 관련 배포 사례는 무엇입니까?
ML Drift는 Apache 2.0으로 공개됐으며 발표에는 별도 이용료가 없습니다. 앱 개발·모델 배포 예산에는 사용할 모델과 함께 묶는 구성요소의 조건, 기기·개발 비용을 별도로 반영합니다. (라이선스 안내)
8월의 Raspberry Pi와 LiteRT 안내는 Pi 5의 WebGPU 경로에 ML Drift를 활용하는 사례를 설명합니다. Reachy Mini에서는 물체 탐지를 GPU에, 음성 인식·Gemma 추론·음성 합성을 CPU에 나눕니다. GPU 사용의 목적이 가장 큰 모델 하나를 무조건 빠르게 돌리는 데만 있지 않고, 동시에 처리할 작업의 자원을 나누는 데도 있다는 예시입니다.
10월 6일 EmbeddingGemma 2 배포 안내는 LiteRT의 사용자 정의 통합, MediaPipe의 준비된 작업 API, 브라우저의 WebGPU 경로를 구분합니다. 기존 검색·영상·음성 앱을 가진 팀이라면 자신이 쓰는 상위 API를 유지할지, 더 낮은 GPU 연산까지 직접 다룰지에 따라 ML Drift의 도입 경로를 고를 수 있습니다.
반응 (2026년 10월 9일 기준)
공개된 사용자 반응은 아직 확인되지 않았습니다.
참고한 자료
확인일은 2026년 10월 9일입니다.