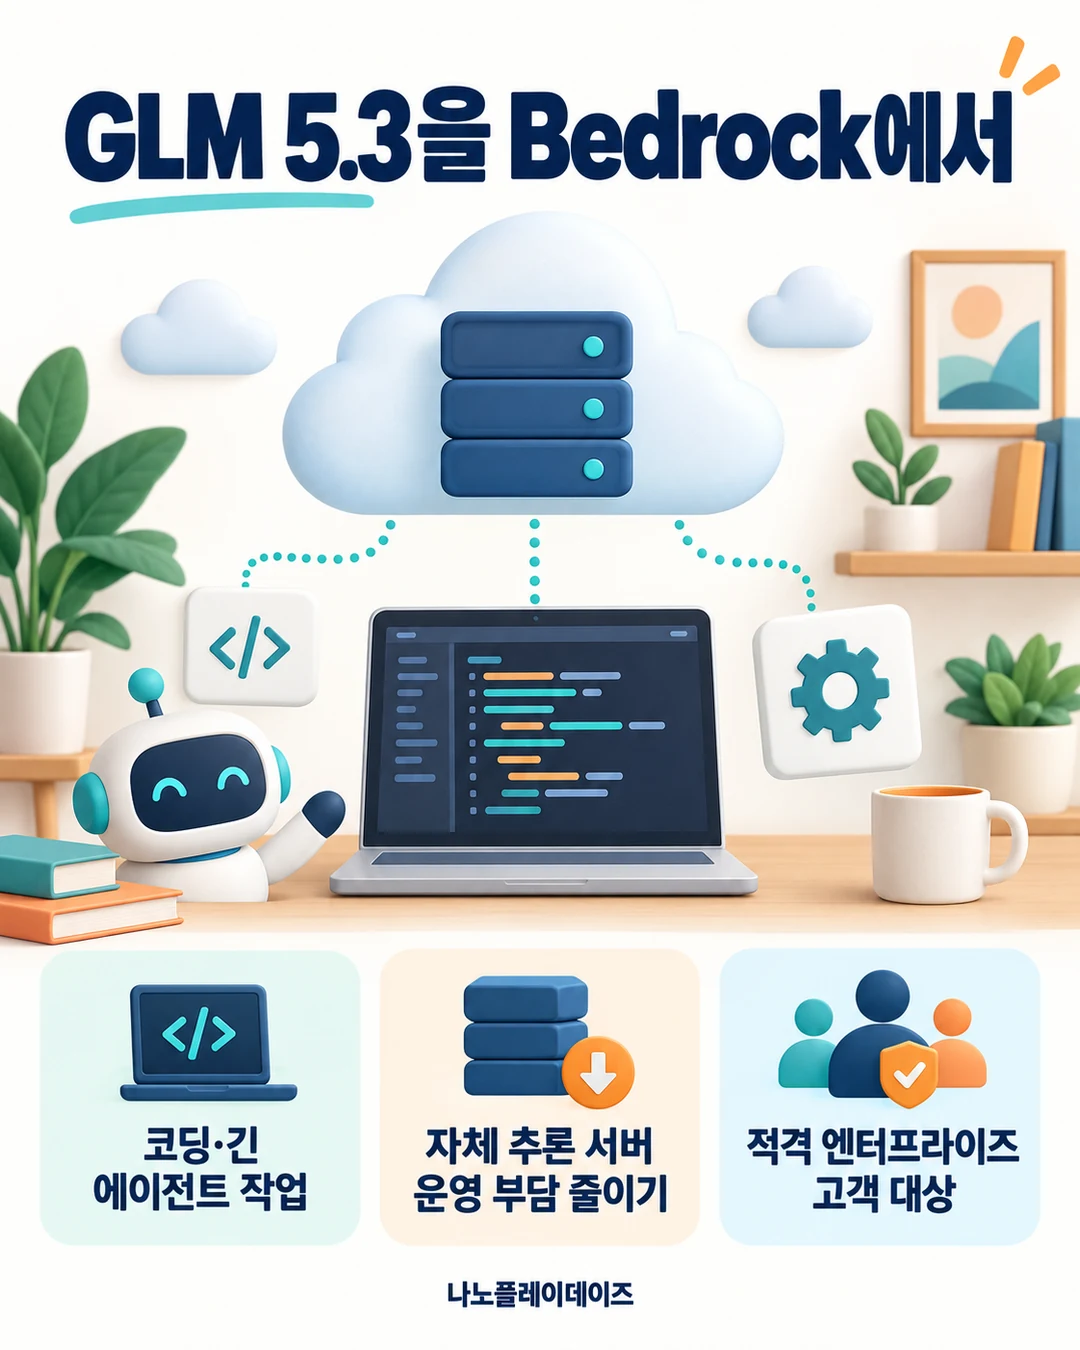
기존 AWS Bedrock 고객은 자체 추론 서버를 운영하는 부담을 줄이면서 GLM 5.3을 코딩·에이전트 작업에 연결할 수 있습니다. AWS가 2026년 10월 5일 발표한 관리형 API 경로입니다. 접근 대상은 적격 엔터프라이즈 고객이고, 서울 리전에서는 전 세계 리전으로 요청을 보내는 Global 프로필로만 호출할 수 있습니다. 가격은 Global 기준 100만 토큰당 입력 3달러·출력 15달러입니다. 리전과 가격을 나눠 확인하는 방법은 기존 그록 Bedrock 안내와 함께 읽을 수 있습니다. (AWS 공식 발표 · GLM 5.3 모델 카드)
한눈에 보기
| 궁금한 점 | 이번 발표의 핵심 |
|---|---|
| 어떤 모델입니까? | Z.ai의 공개 가중치 MoE 모델로, 코딩과 긴 에이전트 작업용입니다. 입력 창은 100만 토큰, 출력은 최대 12만 8천 토큰입니다. |
| 무엇이 바뀝니까? | Bedrock의 관리형 API·교차 리전 추론·프롬프트 캐시·서비스 등급으로 이용합니다. |
| 누구에게 제공됩니까? | 적격 고객으로 제한되며, AWS 계정 팀을 통해 접근 가능 여부를 확인합니다. |
| 어떤 API를 씁니까? | OpenAI 호환 Responses·Chat Completions와 Bedrock Invoke·Converse입니다. |
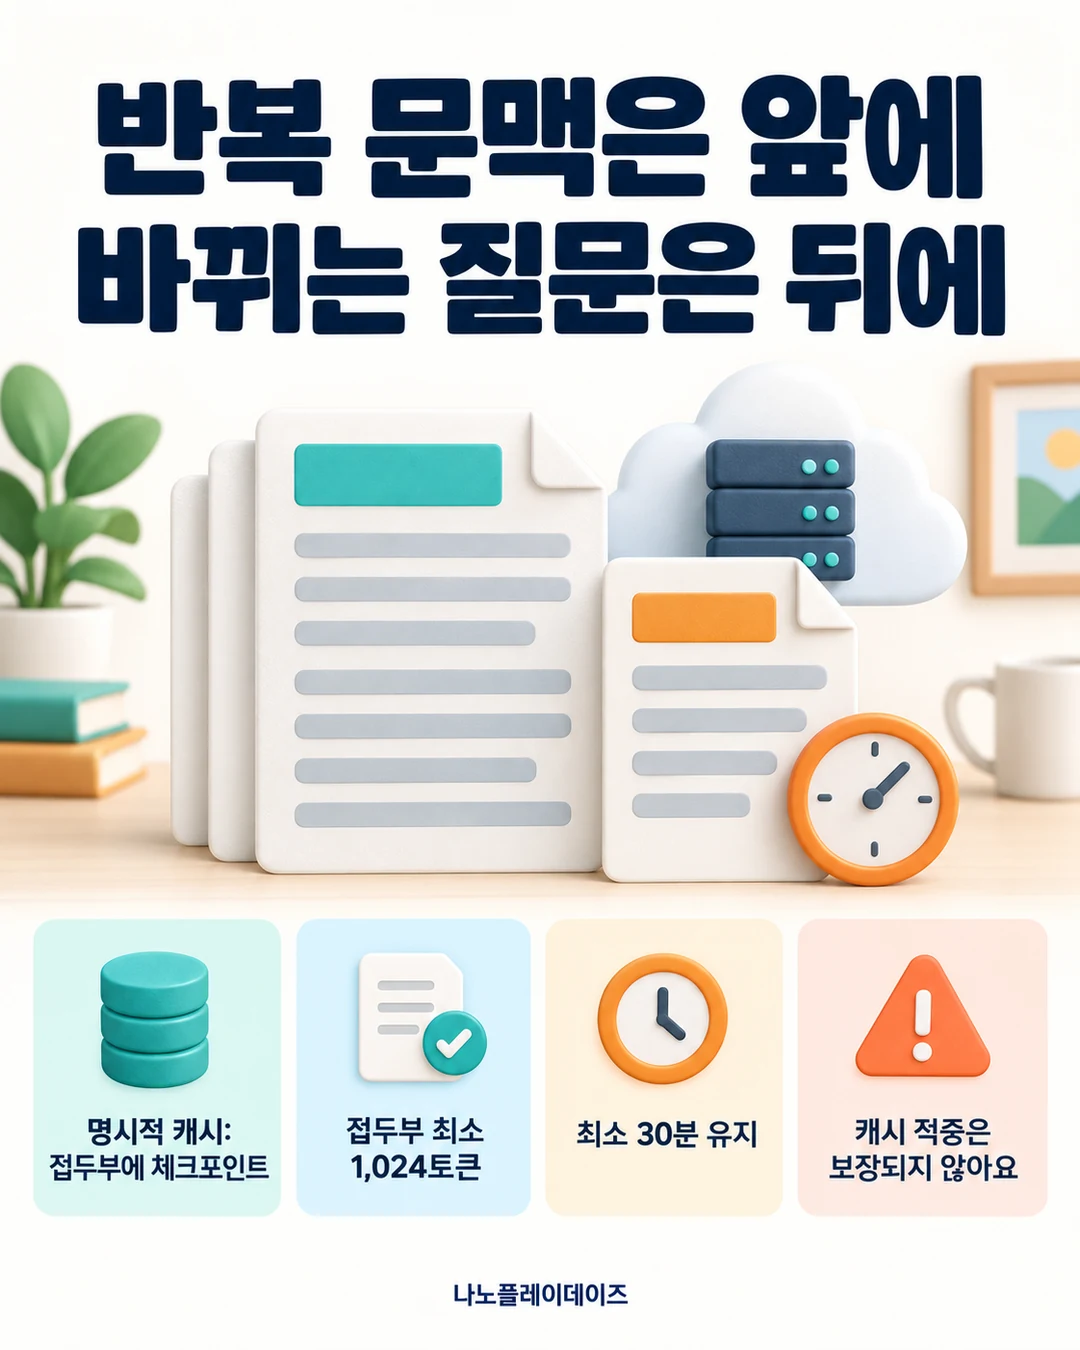
| 캐시는 어떻게 씁니까? | 자동 캐시가 기본이며, 명시적 캐시는 1,024토큰 이상 접두부에 체크포인트를 지정하고 최소 30분 유지됩니다. |
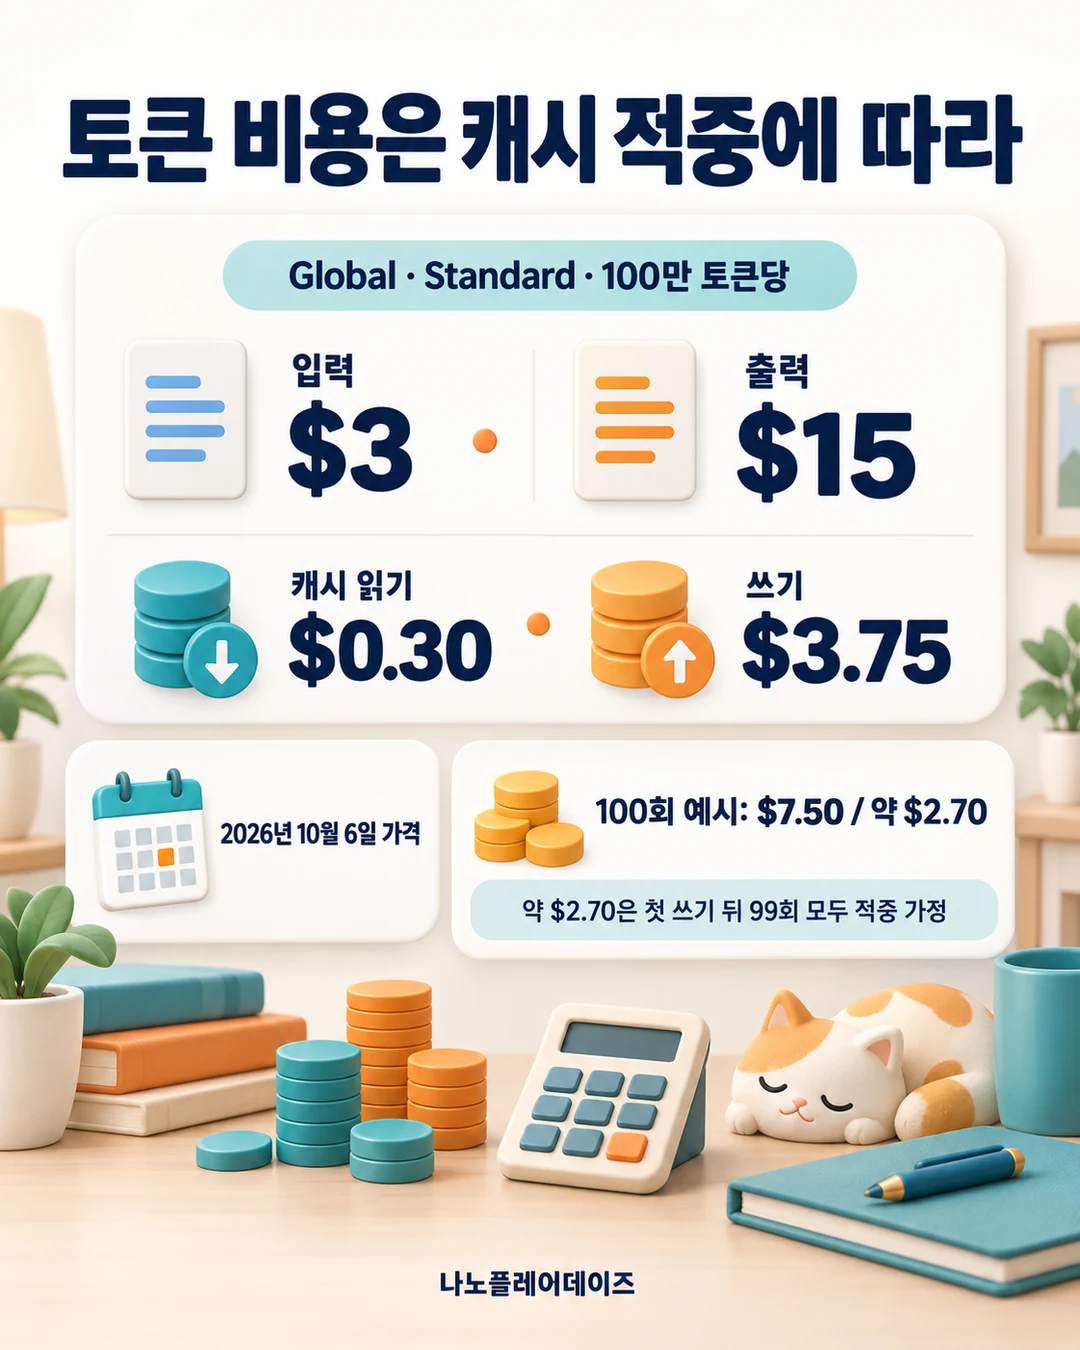
| 비용은 얼마입니까? | Global 프로필 기준 100만 토큰당 입력 3달러, 출력 15달러, 캐시 읽기 0.3달러입니다. US 프로필은 10% 비쌉니다. |
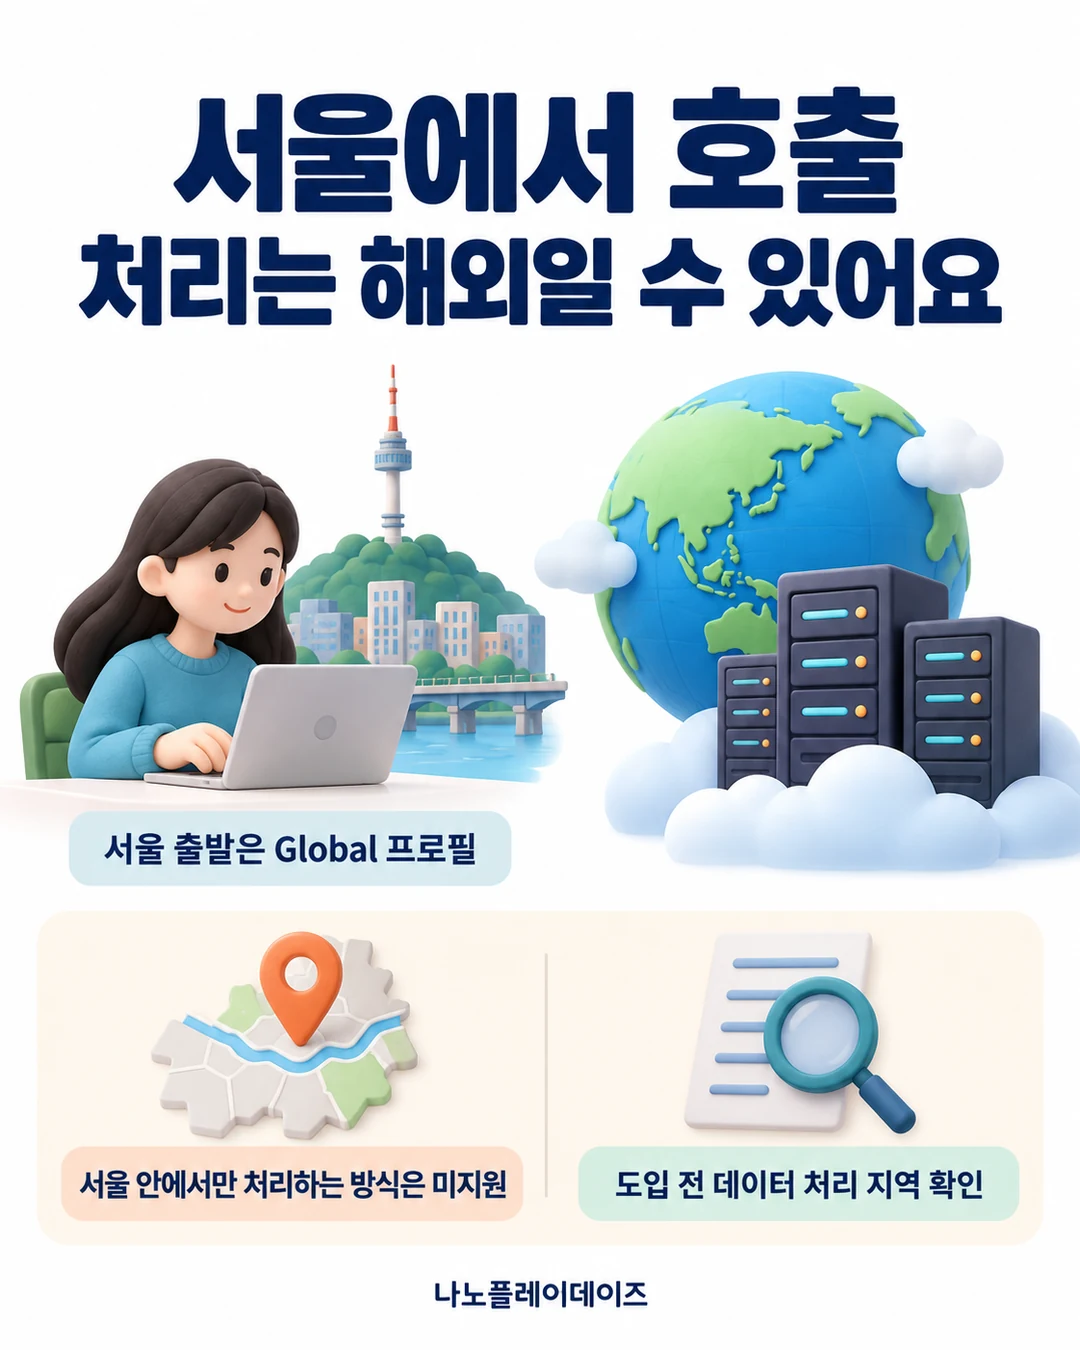
| 한국에서도 쓸 수 있습니까? | 서울(ap-northeast-2)에서 Global 프로필로 호출할 수 있습니다. 서울 안에서만 처리하는 방식은 지원하지 않습니다. |
기능·이용 경로는 AWS 발표와 Bedrock 문서·모델 카드를 따릅니다. 아래 성능 수치는 AWS가 전달한 Z.ai의 주장으로, 독립 비교 결과와 구분합니다. (공식 발표 · 캐시 문서)
코딩과 긴 에이전트 작업에 무엇이 더해집니까?
GLM 5.3은 Z.ai가 만든 공개 가중치 모델입니다. 가중치는 모델이 학습한 값을 뜻하며, MoE(Mixture of Experts)는 여러 전문가 구성 중 입력에 맞는 부분을 사용하는 구조입니다. 전체 파라미터 규모는 AWS 발표에 753B로, Bedrock 모델 카드에는 744B(토큰마다 약 40B 활성)로 적혀 두 공식 문서의 숫자가 다릅니다. 모델 카드에 따르면 GLM 5.2와 같은 기반 모델에 사후 학습을 늘려 개선했고, 입력 창은 100만 토큰, 출력은 최대 12만 8천 토큰입니다. 추론 강도를 골라 지연·토큰 소비와 품질을 맞바꿀 수 있고, 함수 호출·구조화된 JSON 출력·스트리밍을 지원합니다. AWS는 큰 코드 저장소 수정, 여러 단계의 추론과 도구 호출, 오래 이어지는 작업을 주요 용도로 소개합니다. Bedrock 경로에서는 사용자가 이 모델을 올릴 추론 인프라를 직접 마련하지 않고 API로 요청합니다. (공식 발표 · 모델 카드)
발표가 전한 Z.ai 자체 코딩 평가에서는 GLM 5.2보다 50% 개선됐습니다. DeepSWE, Terminal Bench 3.0, FrontierSWE도 경쟁력 있는 성능을 보인 시험으로 언급됩니다. 다만 GLM 5와의 직접 비교는 제시되지 않았고, GLM 5.1 발표 이후 평가 시험 자체가 갱신됐다고 설명합니다. 50%는 코딩 평가의 개선율입니다. 자기 저장소에서 줄어드는 시간은 같은 작업으로 비교해 볼 수 있습니다. (성능 주장의 출처)
보안 작업에서는 Z.ai가 출시 시점의 CyberGym 점수를 84.5로 보고했습니다. 이 역시 제공자 측 평가입니다. 실제 저장소에서 수정이 완성되는지 보려면 코드 변경뿐 아니라 테스트 통과 여부, 도구 권한, 작업 완료 시간과 소비 토큰을 같은 조건으로 살펴보는 것이 유용합니다. 한국어 코딩 지시 품질과 독립적인 장기 작업 비교는 별도 검증 항목으로 남습니다. (공식 발표의 평가 범위)
어디서 제공되며 이용 조건은 무엇입니까?
접근 대상은 원문의 표현대로 “eligible enterprise customers”입니다. 세부 적격 기준은 공개되지 않았고, 모델 카드는 접근이 적격 고객으로 제한되니 AWS 계정 팀에 문의하라고 안내합니다. AWS 계정의 Bedrock 접근 상태와 모델 사용 가능 여부를 먼저 확인하는 순서입니다. 콘솔에서는 Bedrock의 Test → Playground에서 모델 목록의 GLM 5.3을 선택해 프롬프트를 보낼 수 있다고 안내합니다. (제공 조건과 콘솔 경로)
코드 예제의 전제는 Bedrock 접근이 가능한 AWS 계정, 기반 모델과 추론 프로필에 대한 IAM 권한, Python 3.10 이상입니다. IAM은 AWS의 접근 권한 관리 체계이며, 발표는 bedrock:InvokeModel, bedrock:InvokeModelWithResponseStream, bedrock:CallWithBearerToken 권한을 명시합니다. 선택 사항인 Strix 보안 시험에는 Docker와 Bedrock 연동 옵션을 갖춘 Strix 설치가 추가됩니다. (예제 실행 조건)
교차 리전 추론은 요청을 보낸 지역과 실제 처리 지역이 달라질 수 있는 방식입니다. 발표의 프로필 ID는 미국 범위의 us.zai.glm-5.3과 Global 범위의 global.zai.glm-5.3입니다. Bedrock 문서는 출발 리전(Source Region)과 처리 목적지(Destination Region)를 구분하며, 모델 상세 페이지나 GetInferenceProfile 응답으로 실제 목적지를 확인하도록 설명합니다. 데이터 처리 지역에 조건이 있는 조직은 이 구분이 모델 선택에 영향을 줍니다. (공식 발표 · 추론 프로필 문서)
10월 6일 확인한 GLM 5.3 모델 카드의 리전 표에서 서울(ap-northeast-2)은 Global 프로필의 출발 리전으로 지원됩니다. 한 리전 안에서만 처리하는 In-Region 추론은 어느 리전에서도 지원하지 않고, US 프로필은 미국 4개 리전에서만 출발할 수 있습니다. 그래서 서울에서는 global.zai.glm-5.3을 지정하고, 엔드포인트도 bedrock-runtime.ap-northeast-2.amazonaws.com처럼 서울 주소를 씁니다. Global 프로필의 처리 목적지는 모든 상용 리전이라 요청이 한국 밖에서 처리될 수 있습니다. 데이터가 국내에 머물러야 하는 조직에는 이 조건이 걸림돌입니다. 또 서비스 제어 정책(SCP)으로 목적지 리전 중 하나라도 막아 두면 다른 리전이 열려 있어도 요청이 실패하므로, 도입 전에 조직 정책을 확인합니다. (모델 카드 리전 표 · 목적지·SCP 설명)
기존 API 연결에서는 무엇을 바꿉니까?
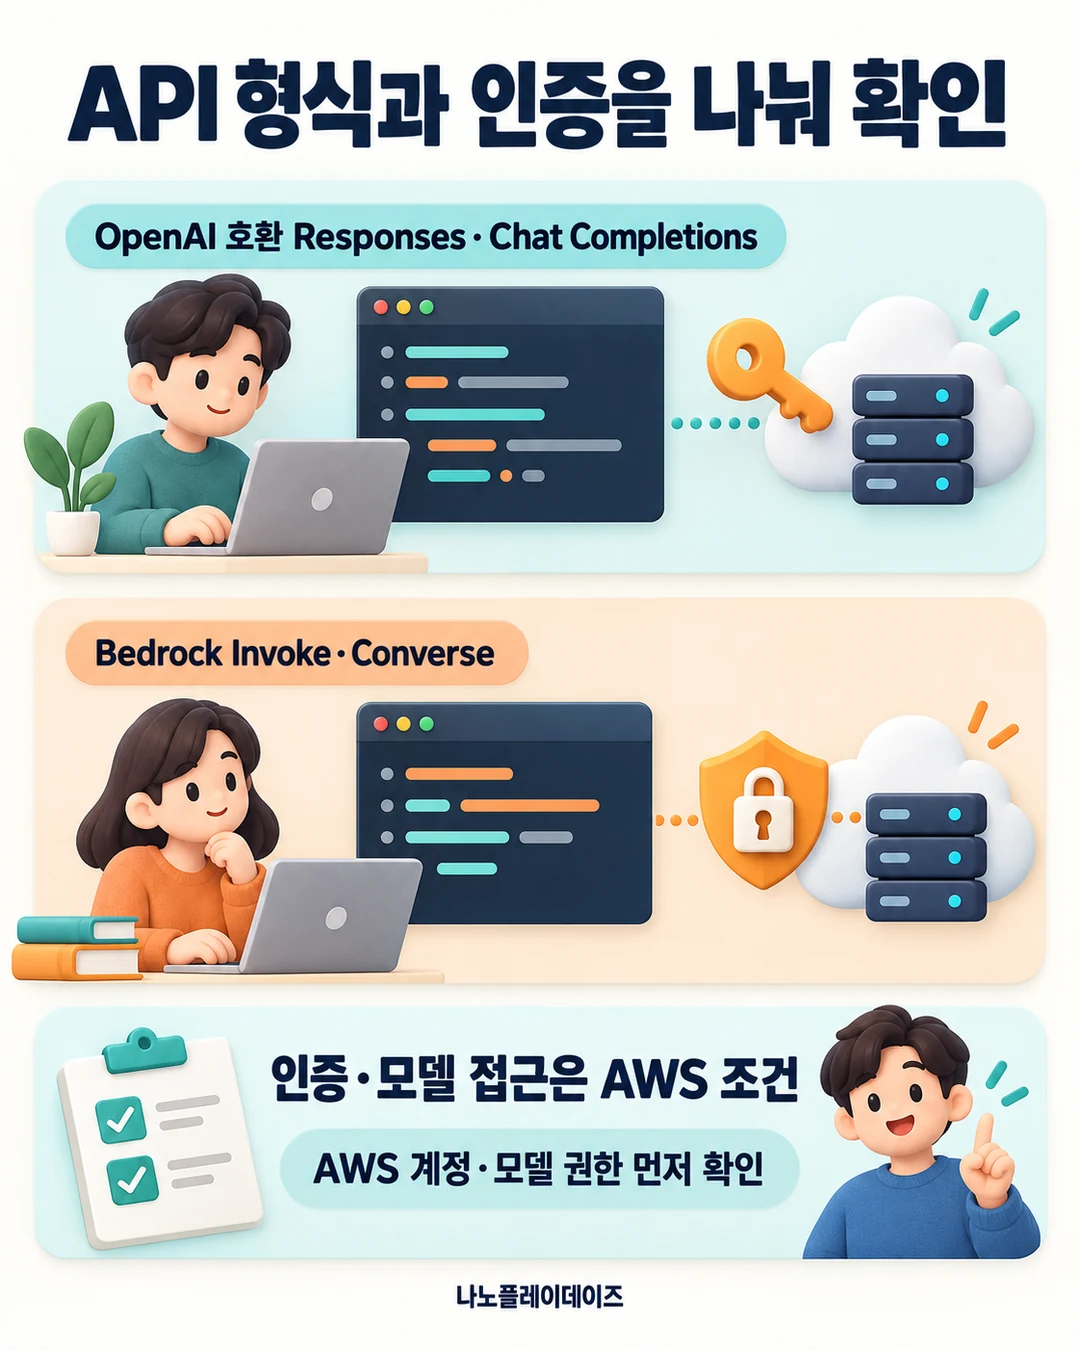
GLM 5.3은 OpenAI 호환 Responses·Chat Completions API와 Bedrock Invoke·Converse API를 지원합니다. AWS는 새 애플리케이션에는 기능 지원이 더 완전한 OpenAI 호환 API를 권장합니다. 이때 요청은 AWS의 bedrock-runtime 엔드포인트로 보내고 모델에는 추론 프로필 ID를 지정합니다. OpenAI 호환이라는 표현은 호출 형식의 호환성을 말하며, 인증과 모델 접근은 AWS 계정의 조건을 따릅니다. (API 연결 안내)
발표의 Python 예제는 openai와 aws-bedrock-token-generator 패키지를 사용합니다. 기존 AWS CLI 자격 증명에서 provide_token(region=region)으로 단기 토큰을 만들고, base_url을 https://bedrock-runtime.{region}.amazonaws.com/openai/v1로 지정한 뒤 client.responses.create()를 호출합니다. 예제의 출발 리전은 오리건(us-west-2), 모델 값은 global.zai.glm-5.3입니다. AWS는 가능한 경우 장기 API 키보다 단기 자격 증명을 권장합니다. (공식 Python 예제)
프롬프트 캐시는 언제 도움이 됩니까?
코딩 에이전트가 같은 시스템 지시나 저장소 문맥을 매 차례 다시 보내면 모델이 반복 입력을 처리하게 됩니다. 프롬프트 캐시는 이 입력의 앞부분, 즉 접두부를 재사용하는 기능입니다. 기본 지원하는 암묵적 캐시는 서비스가 재사용을 시도하며, 명시적 캐시는 사용자가 어느 접두부를 재사용할지 표시합니다. 정적인 내용을 앞에, 매번 바뀌는 질문을 뒤에 두면 접두부를 유지하기 편합니다. (AWS 발표 · 캐시 동작 문서)
발표의 Responses 예제는 요청의 extra_body에 prompt_cache_options: {mode: "explicit"}를 넣고, 재사용할 입력 블록 끝에 prompt_cache_breakpoint: {mode: "explicit"}를 지정합니다. 각 체크포인트 앞의 전체 접두부는 최소 1,024토큰이 캐시 대상 조건입니다. 토큰은 모델이 입력을 처리하는 단위로, 한국어 글자 수와 같지 않습니다. 문서의 최소 길이는 체크포인트 사이 간격이 아니라 해당 지점까지의 누적 접두부에 적용됩니다. (GLM 5.3 설정 예제 · 체크포인트 길이 설명)
접두부가 바뀌면 캐시를 놓칠 수 있고, 같은 입력을 반복해도 적중이 보장되지는 않습니다. 예제는 응답의 usage.input_tokens_details.cached_tokens로 캐시 읽기를 확인합니다. 반복 입력이 많은 팀은 캐시를 켰다는 설정값과 함께 실제 읽힌 토큰 수를 관찰하면 비용 효과를 판단하기 쉽습니다. GLM 5.3 모델 카드는 명시적 캐시의 유지 시간을 최소 30분으로 적고, 적중률을 높여 지연과 비용을 줄일 수 있다며 명시적 캐시 사용을 권장합니다. 30분 안에 같은 접두부로 다시 요청하는 에이전트 반복 작업에 맞는 조건입니다. (캐시 예제 · 모델 카드 캐시 조건)
비용과 서비스 등급은 어떻게 나뉩니까?
2026년 10월 6일 Bedrock 공식 가격표의 GLM 5.3 항목은 아래와 같습니다. 모두 Standard 등급의 100만 토큰당 가격이며, 캐시 쓰기는 30분 유지 기준입니다. (Bedrock 공식 가격표)
| 추론 프로필 | 입력 | 출력 | 캐시 읽기 | 캐시 쓰기(30분) |
|---|---|---|---|---|
| Global | 3.00달러 | 15.00달러 | 0.30달러 | 3.75달러 |
| US | 3.30달러 | 16.50달러 | 0.33달러 | 4.125달러 |
캐시 읽기는 일반 입력의 10분의 1이고, 캐시 쓰기는 일반 입력보다 25% 비쌉니다. 읽히지 않은 토큰은 일반 입력 요율로 과금됩니다. 서울에서는 Global 프로필만 쓸 수 있으니 Global 행이 기준입니다. (캐시 과금 설명)
작업 비용으로 바꿔 보면 이렇습니다. 코딩 에이전트가 한 번에 2만 토큰을 입력하고(그중 1만 8천 토큰은 매번 같은 저장소 문맥) 1천 토큰을 출력하는 호출을 Global Standard로 100번 반복한다고 가정합니다. 캐시 없이는 입력 200만 토큰 6달러와 출력 10만 토큰 1.5달러로 7.5달러입니다. 첫 호출에서 문맥을 캐시에 쓰고 나머지 99번이 모두 적중하면 캐시 쓰기 약 0.07달러, 캐시 읽기 약 0.53달러, 바뀌는 입력 0.6달러, 출력 1.5달러로 약 2.7달러가 됩니다. 약 2.7달러는 나머지 99번이 모두 캐시에 적중한 계산입니다. 실제 적중량은 응답의 cached_tokens에 나옵니다.
| 서비스 등급 | 선택 기준 | 가격(Standard 대비) |
|---|---|---|
| Standard | 약정 없는 기본 사용량 과금입니다. | 위 가격표 그대로 |
| Flex | 시간에 덜 민감한 작업을 더 싸게 처리합니다. | 50% 할인 |
| Priority | 가장 빠른 응답을 위해 처리를 우선합니다. | 75% 할증 |
등급은 모델의 코딩 능력을 바꾸지 않고 요청 처리 순서와 비용만 바꿉니다. 요청마다 service_tier 값을 flex나 priority로 지정하고, 빼면 Standard입니다. 당장 답이 필요한 대화는 Priority, 밤새 돌리는 일괄 리뷰처럼 덜 급한 에이전트 작업은 Flex가 맞습니다. 전용 처리량을 약정하는 Reserved 등급은 GLM 5.3에서 지원하지 않습니다. 등급별 실제 지연 수치는 공개되지 않았습니다. (서비스 등급 안내 · 모델 카드 등급 표 · 등급별 가격 배수)
보안 테스트 예제에서는 무엇을 확인합니까?
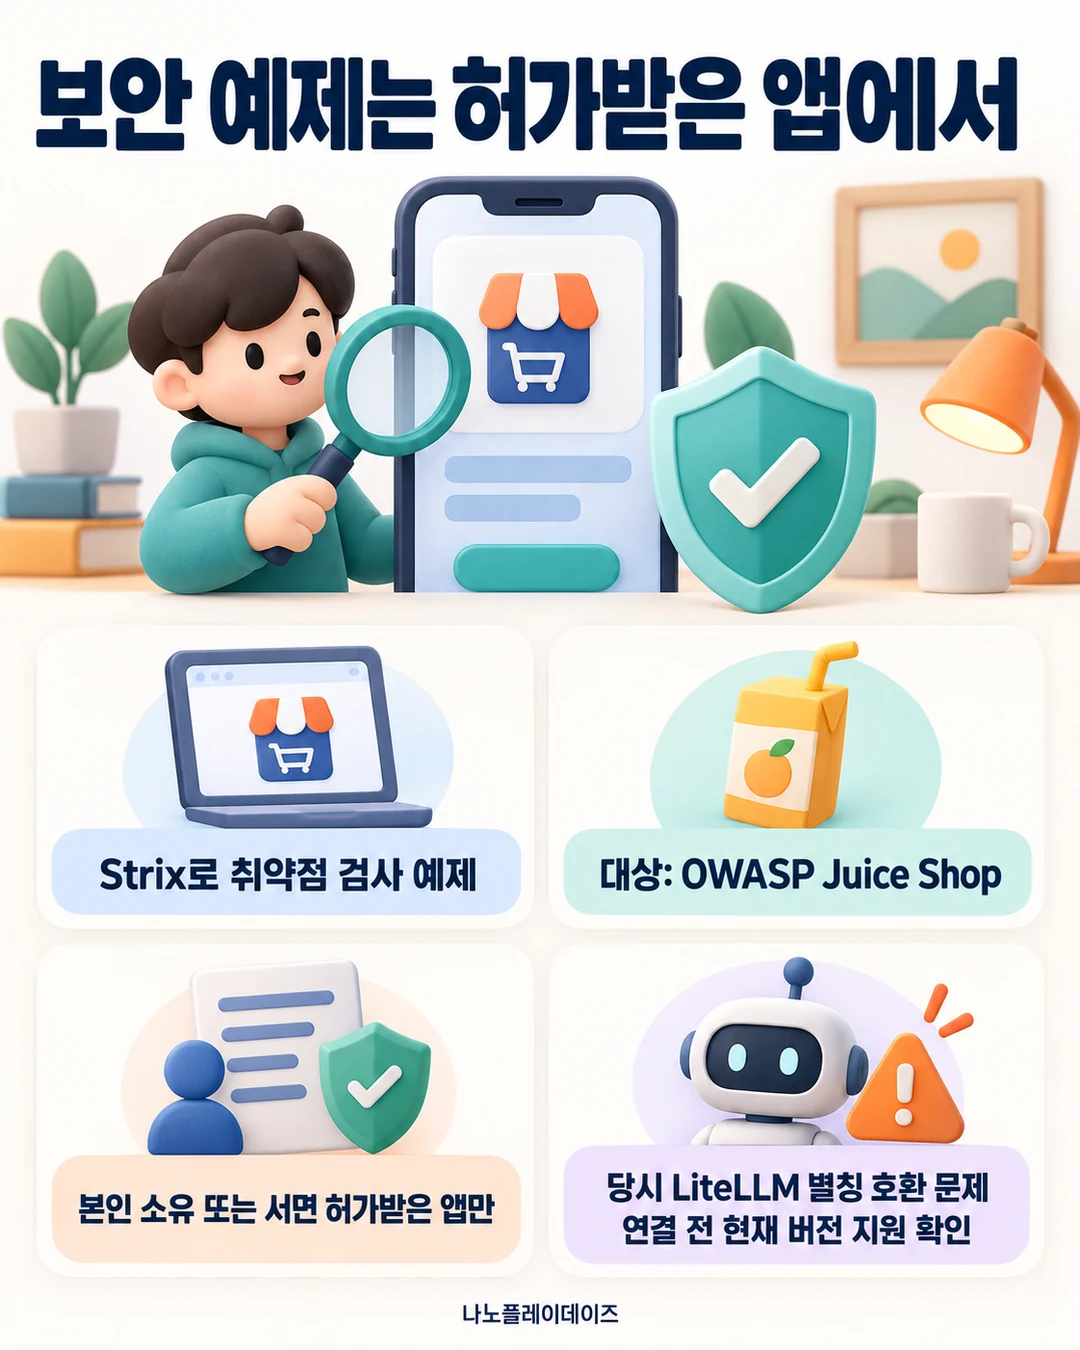
AWS는 GLM 5.3을 Strix에 연결해 앱의 취약점을 찾는 예제를 소개합니다. Strix는 코드를 동적으로 실행하고 발견한 문제를 개념 증명(PoC) 테스트로 검증하는 공개 보안 에이전트입니다. 예제 대상은 로컬에 띄운 의도적으로 취약한 샘플 앱 OWASP Juice Shop입니다. 실제로 시험할 대상은 사용자가 소유하거나 명시적인 서면 허가를 받은 앱으로 제한됩니다. (보안 시험 예제와 허가 조건)
발표 작성 시점에는 Strix가 내부에서 쓰는 LiteLLM이 bedrock/global.zai.glm-5.3 별칭을 해석하지 못했습니다. AWS는 bedrock/converse/ 뒤에 추론 프로필 ARN을 지정하는 우회 설정을 안내합니다. ARN은 AWS 리소스를 식별하는 주소이며, 이 설정에서는 사용자의 리전과 계정 ID를 넣습니다. 이는 해당 연결 예제의 당시 호환성 문제이므로, 통합 도구를 선택할 때는 현재 버전의 모델 별칭 지원을 확인합니다. (Strix·LiteLLM 연결 안내)
발표는 성공한 실행이 심각도·증거·수정 지침을 담은 보고서를 만든다고 설명합니다. 또한 직접 구성하는 Strix와 관리형 보안 평가 서비스 AWS Continuum을 보완적인 경로로 소개합니다. 여기서 확인한 것은 예제의 구성과 기대 결과이며, 실제 취약점 탐지율은 별도 실험으로 평가할 항목입니다. (공식 예제 설명)
반응 (2026년 10월 6일 확인 기준)
공개된 사용자 반응은 아직 확인되지 않았습니다.
참고한 자료
확인일은 2026년 10월 6일입니다.
- AWS GLM 5.3 Bedrock 발표: 제공 조건·API·프로필·캐시 설정·서비스 등급·Strix 예제입니다.
- Bedrock GLM 5.3 모델 카드: 파라미터·입출력 길이·리전 표·캐시 유지 시간·서비스 등급입니다.
- Bedrock 프롬프트 캐시 문서: 접두부·체크포인트·적중 여부·과금 조건입니다.
- Bedrock 추론 프로필 지원 문서: 출발 리전과 처리 목적지의 구분·확인 방법입니다.
- Bedrock 공식 가격표: GLM 5.3의 프로필별 입력·출력·캐시 단가와 등급별 배수입니다.