Codex를 오래 돌리다 보면 하던 일을 잠깐 멈추고 대화를 압축할 때가 있어요. 그 요약 한 번을 약 4배 싸게 만들었는데, 전체 비용은 거의 그대로였어요. 기록을 나란히 놓으니, 압축 한 번의 가격이 낮아지는 동안 압축 횟수는 늘고 있었어요.
대화가 길어질수록 사용량이 빨리 줄어드는 게 고민이라면, 압축 기준부터 무작정 낮추기 전에 볼 숫자가 있어요. 몇 요청마다 압축하는지, 압축 뒤 대화가 얼마나 남는지, 바로 다음 요청이 캐시를 얼마나 쓰는지. 저희가 돌아서 배운 순서예요.
대화를 줄이는 데도 사용량이 든다
압축은 앞선 대화와 작업 내용을 읽고, 이어서 일하는 데 필요한 내용을 요약하는 과정이에요. 긴 대화를 짧게 만들지만, 그 요약을 만들 때도 모델이 일을 해요.
이미 읽었던 입력을 싸게 다시 쓰는 기능을 캐시라고 해요. 저희 기록에서는 압축 요청이 캐시를 거의 활용하지 못했고, 압축 뒤 첫 요청도 캐시를 놓쳤어요. 대화가 새로 정리된 직후에 사용량이 한 번 더 튄 셈이에요.
2026년 10월, 저희 AI 도구 운영 담당이 사용 기록을 대조했어요. 하루 기록에서 압축 요청 159회가 약 919크레딧, 압축 직후 요청이 약 313크레딧이었어요. 합치면 약 1,232크레딧으로, 하루 약 4,100크레딧의 30% 정도였죠.
여기서 크레딧은 기록된 토큰을 Codex 공식 단가표로 환산한 값이에요. 실제 청구액이나 구독 잔량에서 차감된 양을 뜻하지는 않아요. 아래 비교도 같은 방식으로 계산했어요.
먼저 압축하면 더 싸질 줄 알았다
처음에는 대화가 약 21만 토큰까지 커진 다음 약 4.7만 토큰으로 줄어들었어요. 이건 당시 저희 환경에서 관찰한 크기예요. 공식 문서상 압축 기준을 지정하지 않으면 모델별 기본값을 사용해요.
대화를 덜 읽으면 요약 비용도 줄겠다고 보고, 12만 토큰에서 먼저 압축하도록 바꿨어요. 첫 계산에는 실행 한 번당 비용이 21% 줄었다는 값이 나왔죠.
첫 계산은 입력·캐시 입력·출력 토큰의 가중치를 어림으로 잡은 값이었어요. 공식 단가로 다시 계산하니 요청당 감소 폭은 약 8%였어요. 어떤 토큰을 얼마로 셌는지에 따라 절감률부터 달라졌어요.
이번에는 12만에서 16만으로 늦춰 봤다
압축을 너무 자주 하고 있는 건 아닐까. 이번에는 네 에이전트의 기준을 12만에서 16만 토큰으로 올리고, 다른 세 에이전트는 12만을 유지했어요.
10월 20일 오전 6시 35분부터 밤 10시 24분까지의 기록과, 그 뒤 10월 23일 오전 7시까지의 기록을 비교했어요. 한국 시각 기준이에요.
| 비교한 항목 | 12만→16만으로 변경 | 12만 유지 |
|---|---|---|
| 변경 전 요청당 크레딧 | 0.908 | 0.674 |
| 변경 후 요청당 크레딧 | 0.800 | 0.744 |
| 전후 변화 | 약 11.9% 감소 | 약 10.5% 증가 |
| 압축까지 요청 간격 | 평균 17.0→24.7회 | 약 14→16회 |
요청당 값은 변경 그룹에서 4,137.3 ÷ 4,558과 3,921.4 ÷ 4,905로 계산했어요. 유지 그룹은 815.2 ÷ 1,210과 352.0 ÷ 473이에요. 압축 요청도 포함했어요.
변경한 쪽은 압축 직전 대화가 약 11.4만에서 14.9만 토큰으로 커졌지만, 압축 사이에 일을 더 했어요. 같은 파일을 다시 읽는 비중도 0.7%에서 0.2%로 줄었고요. 다만 파일 재독만으로 작업 품질 전체를 판단할 수는 없어요.
이 비교에서는 16만으로 바꾼 그룹의 실행당 요청 수가 평균 86회에서 45회로 줄었어요. 실행 한 번이 싸졌다고 같은 양의 일을 싸게 했다고 말할 수는 없었어요. 그래서 비용 합계를 요청 수로 나눴어요. 요청당 비교도 업무 난이도까지 같게 만들어 주지는 않아요.
이 환경에서는 압축을 조금 늦춘 쪽의 요청당 비용이 내려갔어요. 다만 12만 유지 그룹의 변경 후 기록은 10실행·473요청으로 표본이 작아요. 네 에이전트와 세 에이전트의 업무를 무작위로 똑같이 나눈 실험도 아니어서, 16만을 누구에게나 맞는 값으로 권할 수는 없어요.
한 번은 4배 싸졌는데, 합계는 왜 그대로일까
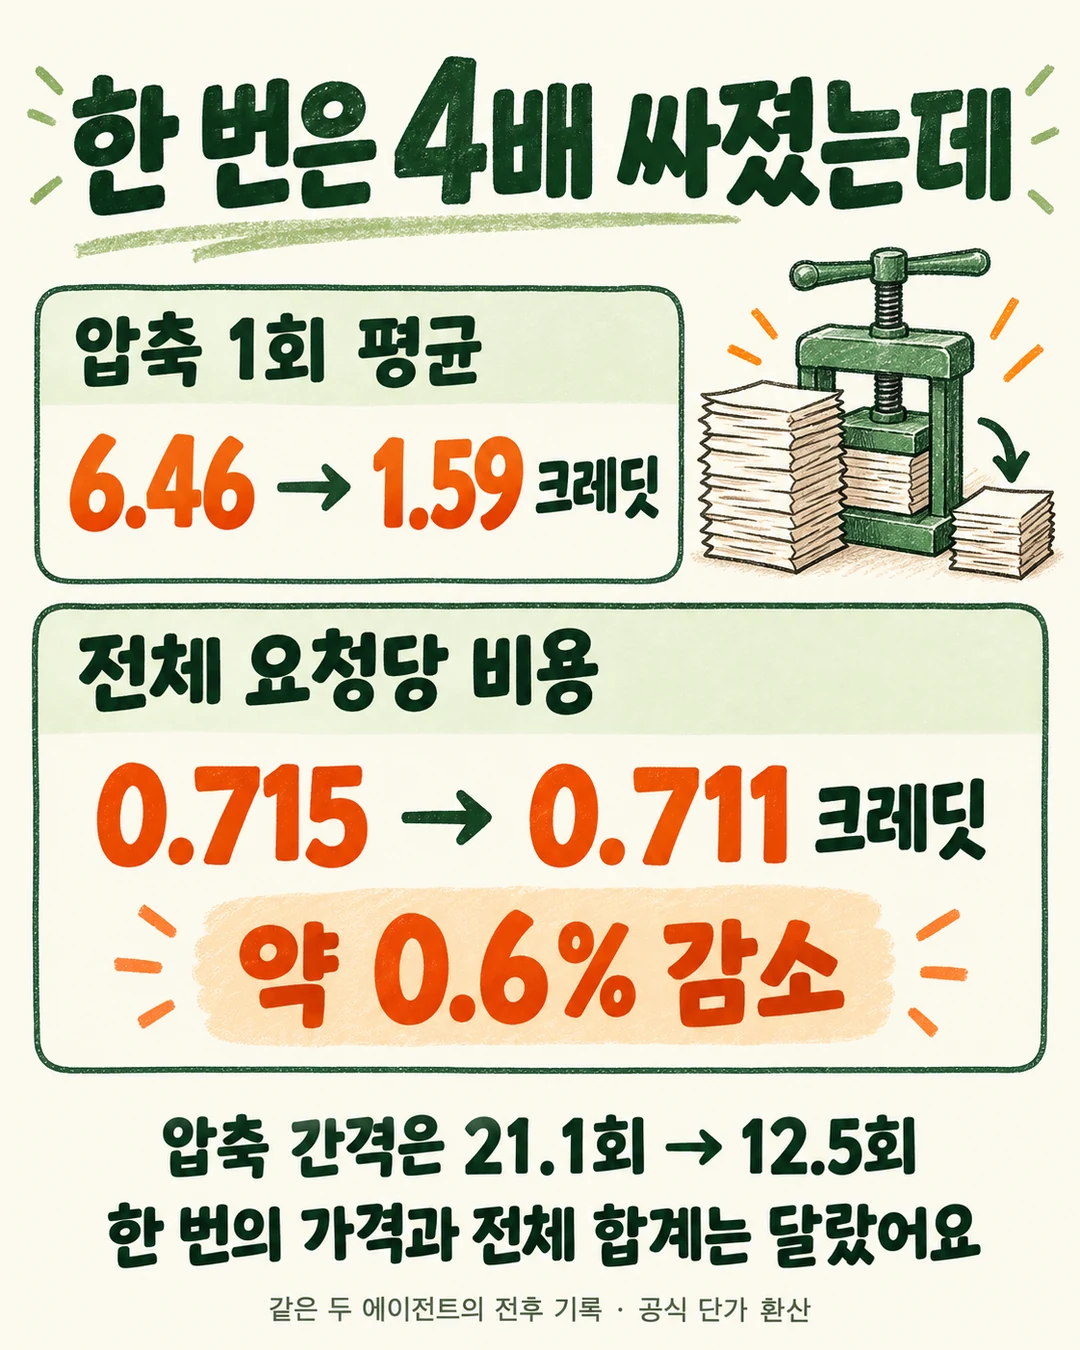
다른 비교에서는 압축을 서버 쪽 기능에 맡기는 원격 압축을 살펴봤어요. 같은 두 에이전트의 기록에서 로컬 압축 한 번은 평균 6.46크레딧, 원격 압축은 평균 1.59크레딧이었어요. 한 번만 보면 약 4배 싸졌죠.
그런데 전체를 합치니 이야기가 달라졌어요.
| 같은 두 에이전트의 기록 | 원격 압축 전 | 원격 압축 후 |
|---|---|---|
| 전체 크레딧 | 2,047.5 | 1,860.4 |
| 요청 수 | 2,863 | 2,617 |
| 요청당 크레딧 | 약 0.715 | 약 0.711 |
| 압축 뒤 대화 크기 | 약 4.5만 토큰 | 약 7.5만 토큰 |
| 압축까지 요청 간격 | 평균 21.1회 | 평균 12.5회 |
전체 요청당 비용은 약 0.6% 감소. 거의 그대로예요.
원격 압축은 요약을 더 길게 남겼어요. 압축 기준이 12만인데 요약 뒤에 이미 7.5만이 남으니, 다음 압축까지 여유가 4.5만 토큰밖에 없었죠. 압축 간격은 약 21회에서 약 13회로 짧아졌어요. 한 번이 싸진 대신, 약 1.7배 자주 압축했어요.
기다리는 시간도 늘었어요. 완료까지 잰 압축은 평균 85초에서 107초로 길어졌고, 해당 실행들의 기록된 시간 중 압축이 차지한 비중은 17.3%에서 28.1%로 커졌어요.
이 비교는 10월 20일 밤 10시 24분~21일 밤 9시 58분과, 그 뒤 23일 오전 7시까지예요. 같은 기간에 원격 압축을 쓰지 않은 대조군은 없어서, 전후의 업무 차이도 함께 섞여 있어요.
빠진 요청을 더하니 절감률도 달라졌다
이 계산에서도 한 번 더 고칠 게 있었어요. 원격 압축 요청은 일반 세션 사용량에 안 잡혔어요. 그 기록만 보면 줄어든 비용이 실제보다 크게 보였죠.
중계 기록에서 원격 압축 155회를 하나씩 맞춰 찾았고, 빠진 246.2크레딧을 더했어요. 변경 후 합계는 이렇게 됐어요.
일반 세션 기록 1,614.2
+ 원격 압축 246.2
= 1,860.4크레딧

1,860.4 ÷ 2,617요청
≈ 요청당 0.711크레딧
압축을 다른 경로로 옮겼다면 그 경로의 사용량도 합계에 들어왔는지 먼저 봐야 해요. 대시보드 숫자가 줄었다고 실제로 덜 썼다고 볼 수 없는 이유예요.
내 Codex에서는 세 숫자부터 적어 보면 된다
Codex의 압축 기준 설정은 공식 설정 문서의 model_auto_compact_token_limit이에요. 이미 사용하는 config.toml에서 아래처럼 지정할 수 있어요.
model_auto_compact_token_limit = 160000
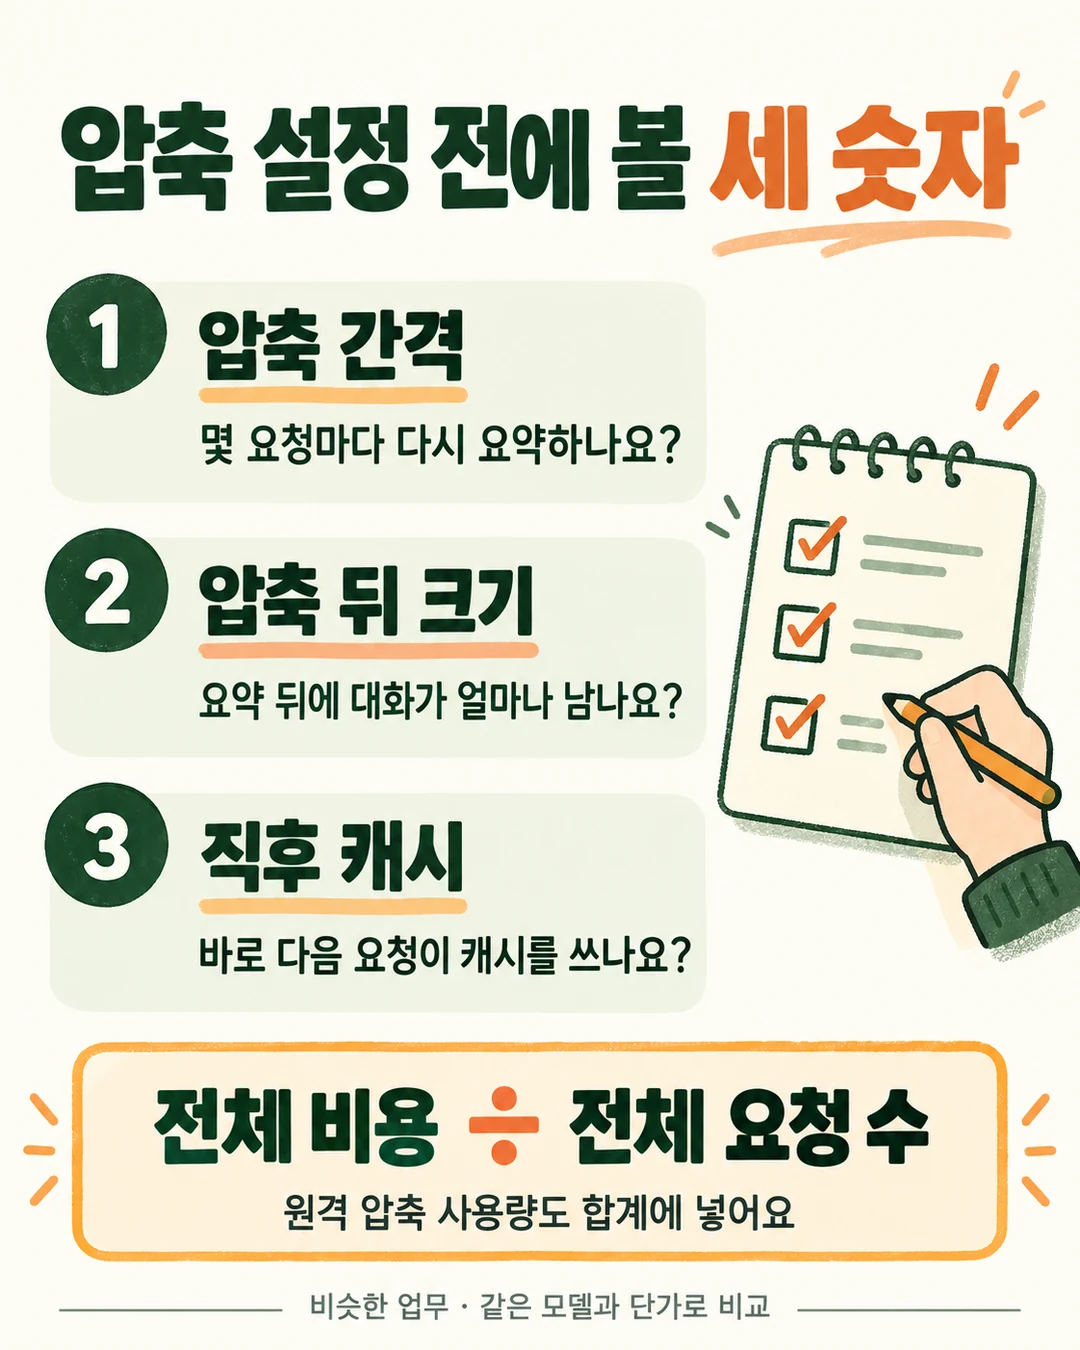
이 값은 이번 비교에서 쓴 16만 토큰이에요. 설정을 바꾸기 전후, 비슷한 일을 맡긴 구간에서 아래 세 칸을 먼저 채워 보세요. 사용하는 도구의 사용량 기록에 해당 값이 있어야 비교할 수 있어요.
| 적어 둘 것 | 기록에서 찾을 값 | 달라졌을 때 볼 점 |
|---|---|---|
| 압축 간격 | 직전 압축 시작부터 다음 압축 시작까지 요청 수 | 너무 자주 요약하느라 이득을 쓰고 있나 |
| 압축 뒤 크기 | 요약 완료 뒤 남은 입력 토큰 수 | 다음 기준까지 여유가 얼마나 남나 |
| 직후 캐시 | 바로 다음 요청의 캐시 입력 토큰 ÷ 전체 입력 토큰 | 요약 다음 요청에서 비용이 다시 뛰나 |
첫 압축은 실행 시작부터 세고, 마지막 압축 뒤에 남은 요청은 간격 평균에서 빼요. 그래서 총요청 수를 압축 횟수로 나눈 값과는 달라요. 캐시 입력이 별도로 표시되지 않으면 그 칸을 추측해서 채울 필요는 없어요.
그리고 비용 합계는 전체 요청 수로 나눠 보세요. 모델과 속도, 업무 종류가 달라졌다면 함께 적어 두고요. 저희는 GPT-6.1 Sol의 입력·캐시 입력·출력을 각각 100만 토큰당 50·2.5·250크레딧으로 계산했어요. 다른 모델을 쓰면 그 모델 단가를 적용해야 해요.
지금은 원격 압축과 16만 기준을 함께 쓰는 실험도 진행 중이에요. 아직 결과는 없어요. 이번에 확실히 가져갈 것은 설정값 하나보다, 압축 한 번의 가격 뒤에 숨은 횟수와 직후 요청까지 세는 방법이에요.