설명만 읽어서는 감이 오지 않는 질문에 ChatGPT가 직접 눌러 보고 값을 바꾸는 화면으로 답하기 시작합니다. OpenAI는 2026년 10월 7일 GPT-6의 Intelligent UI를 발표했습니다. 질문에 맞춰 그래픽·버튼·폼·차트·대화형 경험을 구성하는 기능이며, 자기 요금제의 배포 일정과 Chat 탭에서 기능이 보이는지부터 확인하면 됩니다. (공식 발표)
초기 토론에는 시각적 설명을 반기는 기대와 화면 장식이 지나치다는 우려가 함께 있습니다. 이번 변화는 기존 GPT-6.1 Sol 글에서 다룬 작업용 모델 선택과 별도로, 일상 대화의 답변 형식을 바꿉니다. (HN 출시 토론)
한눈에 보기
| 궁금한 점 | 이번 발표의 핵심 |
|---|---|
| 무엇이 바뀝니까? | 질문에 따라 글·그림·버튼·폼·차트와 대화형 도구를 조합합니다. |
| 어떤 작업에 맞습니까? | 관계를 눈으로 살피는 설명, 조건을 바꾸는 계산, 항목 비교에 활용할 수 있습니다. |
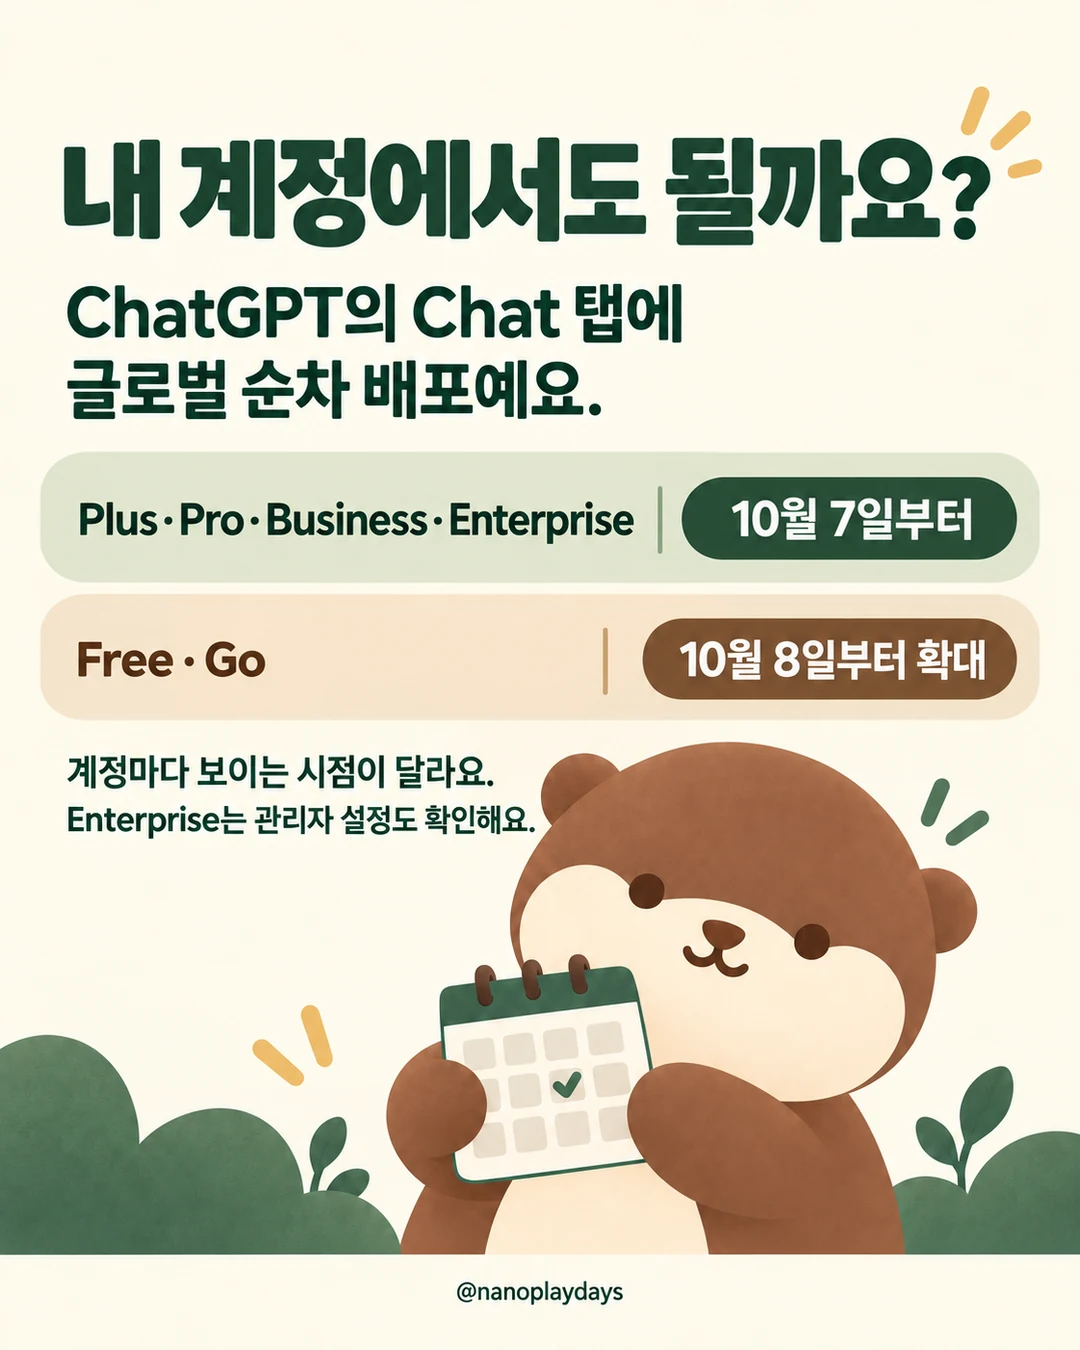
| 유료 플랜은 언제 시작합니까? | Plus·Pro·Business·Enterprise의 Chat 탭에서 10월 7일부터 글로벌 순차 배포합니다. |
| 무료 계정도 포함됩니까? | Free·Go는 10월 8일부터 확대 배포 예정입니다. |
| 어떤 모델을 씁니까? | 유료 네 플랜은 GPT-6 Sol, Free·Go는 GPT-6 Luna입니다. |
| 비용은 어떻게 됩니까? | ChatGPT 요금제 안에서 제공하며 별도 기능 요금은 발표하지 않았습니다. |
| 회사 계정의 조건은 무엇입니까? | Enterprise 제공은 직장 관리자의 설정에 좌우됩니다. |
| Work·Codex도 바뀝니까? | 이번 발표로 해당 환경을 구동하는 모델은 바뀌지 않습니다. |
기능·일정은 공식 발표, 모델 버전과 안전 평가 조건은 10월 시스템 카드를 따릅니다. 속도는 OpenAI 내부 평가 주장이고, 아래 활용 예시는 직접 시험한 결과와 구분합니다. 확인 기준은 2026년 10월 8일입니다. (발표 · 시스템 카드)
Intelligent UI는 기존 채팅과 무엇이 다릅니까?
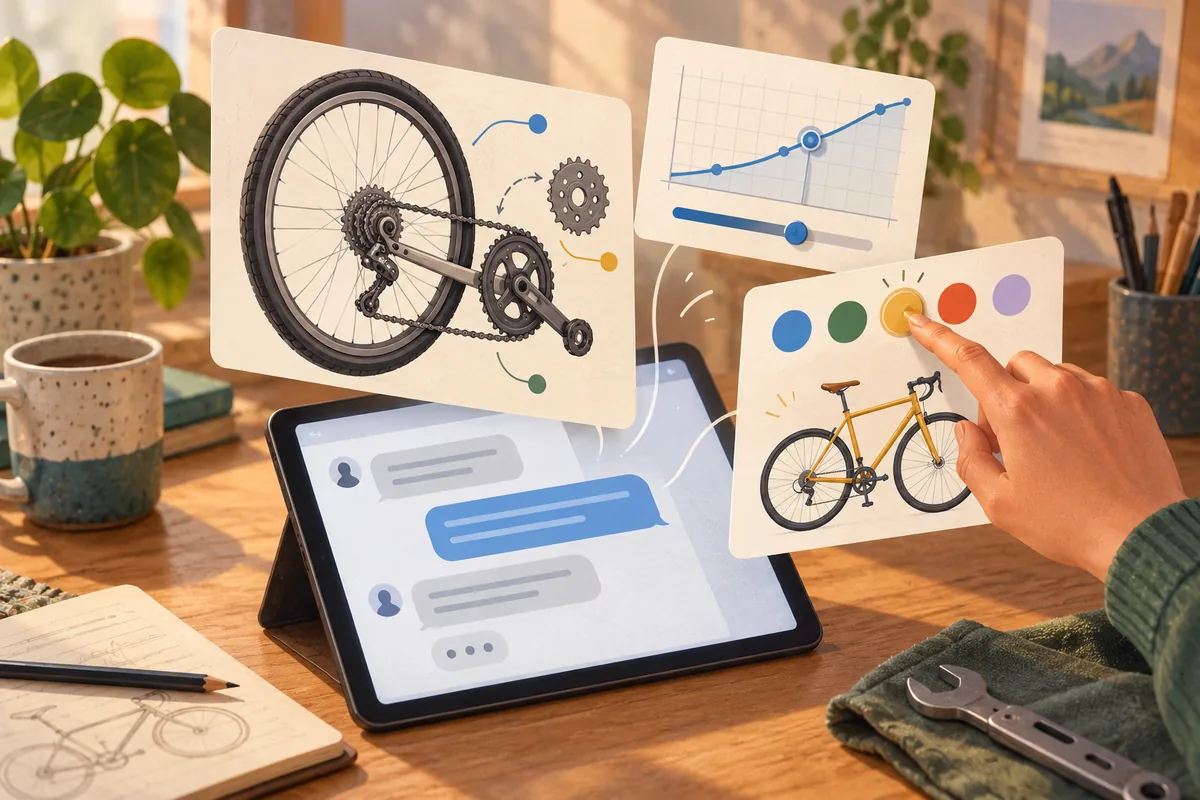
UI는 사용자가 정보를 읽고 조작하는 화면을 뜻합니다. Intelligent UI에서는 답변 자체에 조작 요소가 들어갑니다. OpenAI는 GPT-6가 글·시각 자료·조작 요소를 질문에 맞춰 어떻게 섞을지 스스로 고르도록 학습됐다고 설명합니다. 비교 질문은 나란히 놓인 패널로, 개념 설명은 눌러 볼 수 있는 도식으로 나올 수 있고, 단순한 질문에는 지금처럼 글 답변이 나옵니다. 즉 사용자가 모드를 고르는 기능이 아니라 모델이 답변 형식을 정하는 변화입니다. (기능 설명)
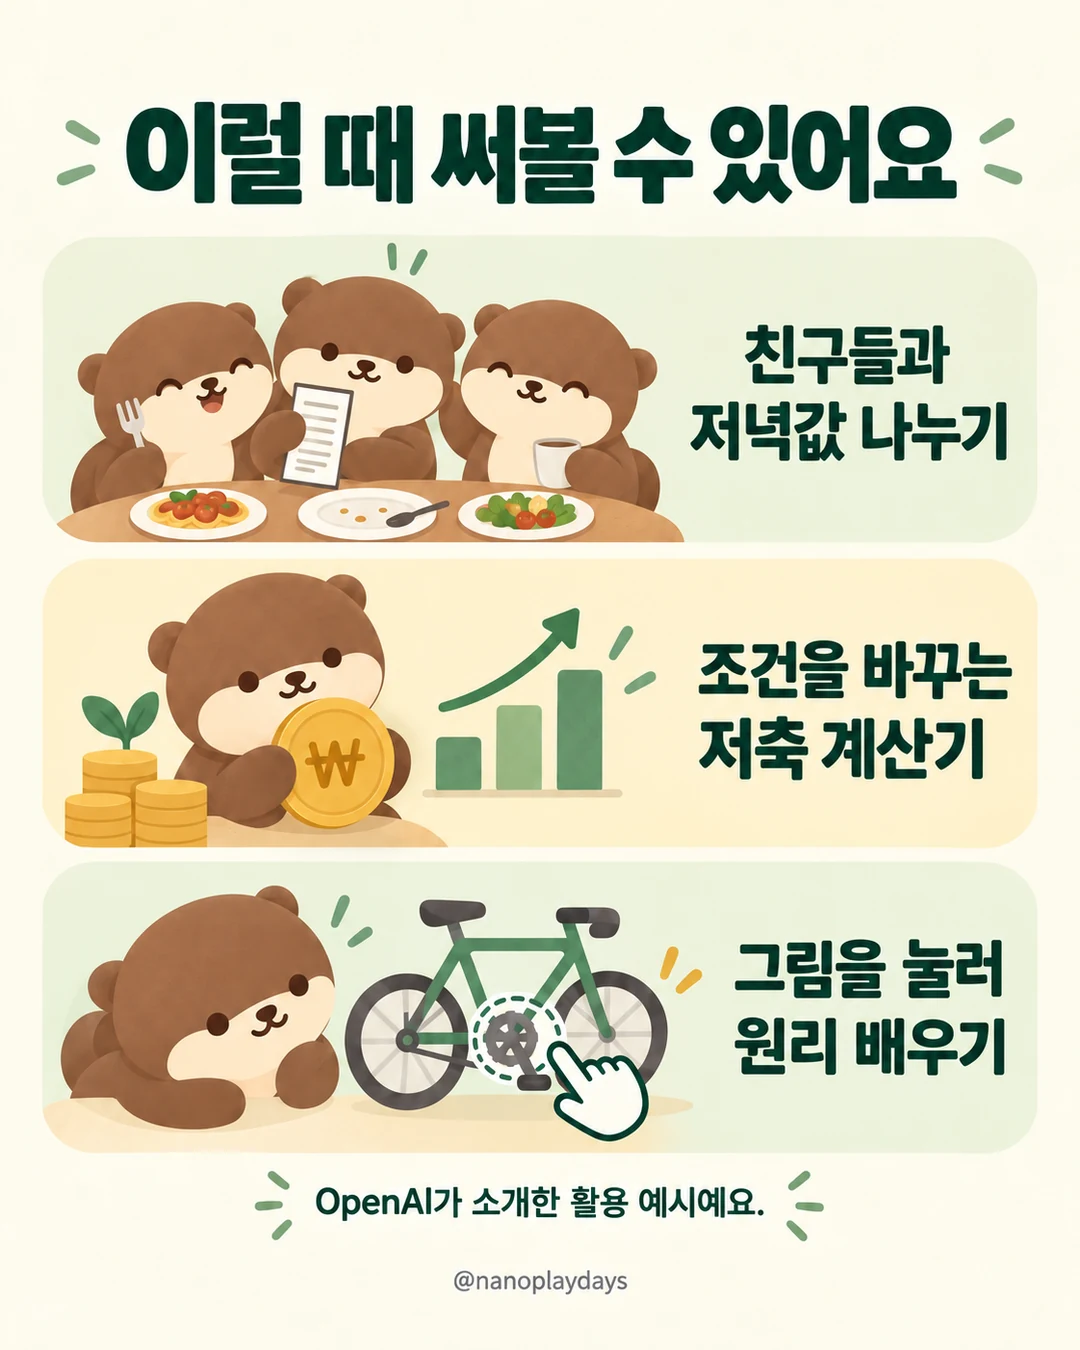
발표 시연에는 비행기 날개의 공기 흐름 도식, 요리법 시각 자료, 자전거 구동부 그림, 등산 지도, 개인 저축 계산기가 나왔습니다. 예컨대 자전거 부품의 역할을 배울 때 긴 설명을 순서대로 읽는 대신, 관심 있는 부위를 눌러 그 부분의 설명을 살피는 흐름입니다. (TechCrunch 보도)
독자에게 중요한 기준은 그림의 개수보다 조작의 목적입니다. “이 개념을 설명해 주세요”에 더해 “입력값을 바꾸면 결과가 어떻게 변하는지 보여 주세요”라고 요청하면, 자신이 탐색하려는 관계를 분명하게 전달할 수 있습니다. 반대로 정의 한 줄이나 짧은 사실 확인처럼 바로 읽고 끝낼 질문에는 간결한 글 답변이 편합니다. 기능을 비교할 때도 원하는 정보를 찾는 데 걸리는 단계와 수정하기 쉬운지를 함께 살필 수 있습니다.
어떤 질문을 대화형 도구로 바꾸면 도움이 됩니까?
학습에서는 조건과 결과의 관계를 탐색하는 질문이 좋은 출발점입니다. 확률 문제라면 선택지를 바꾸며 결과를 비교하고, 계산이라면 입력값과 계산 가정을 함께 표시하도록 요청할 수 있습니다. 화면에 숫자가 움직인다는 사실과 수식이 맞는지는 별개의 확인 항목입니다. 자신의 교재나 원래 계산식에 나온 간단한 사례를 넣어 결과를 대조하는 방식이 유용합니다.
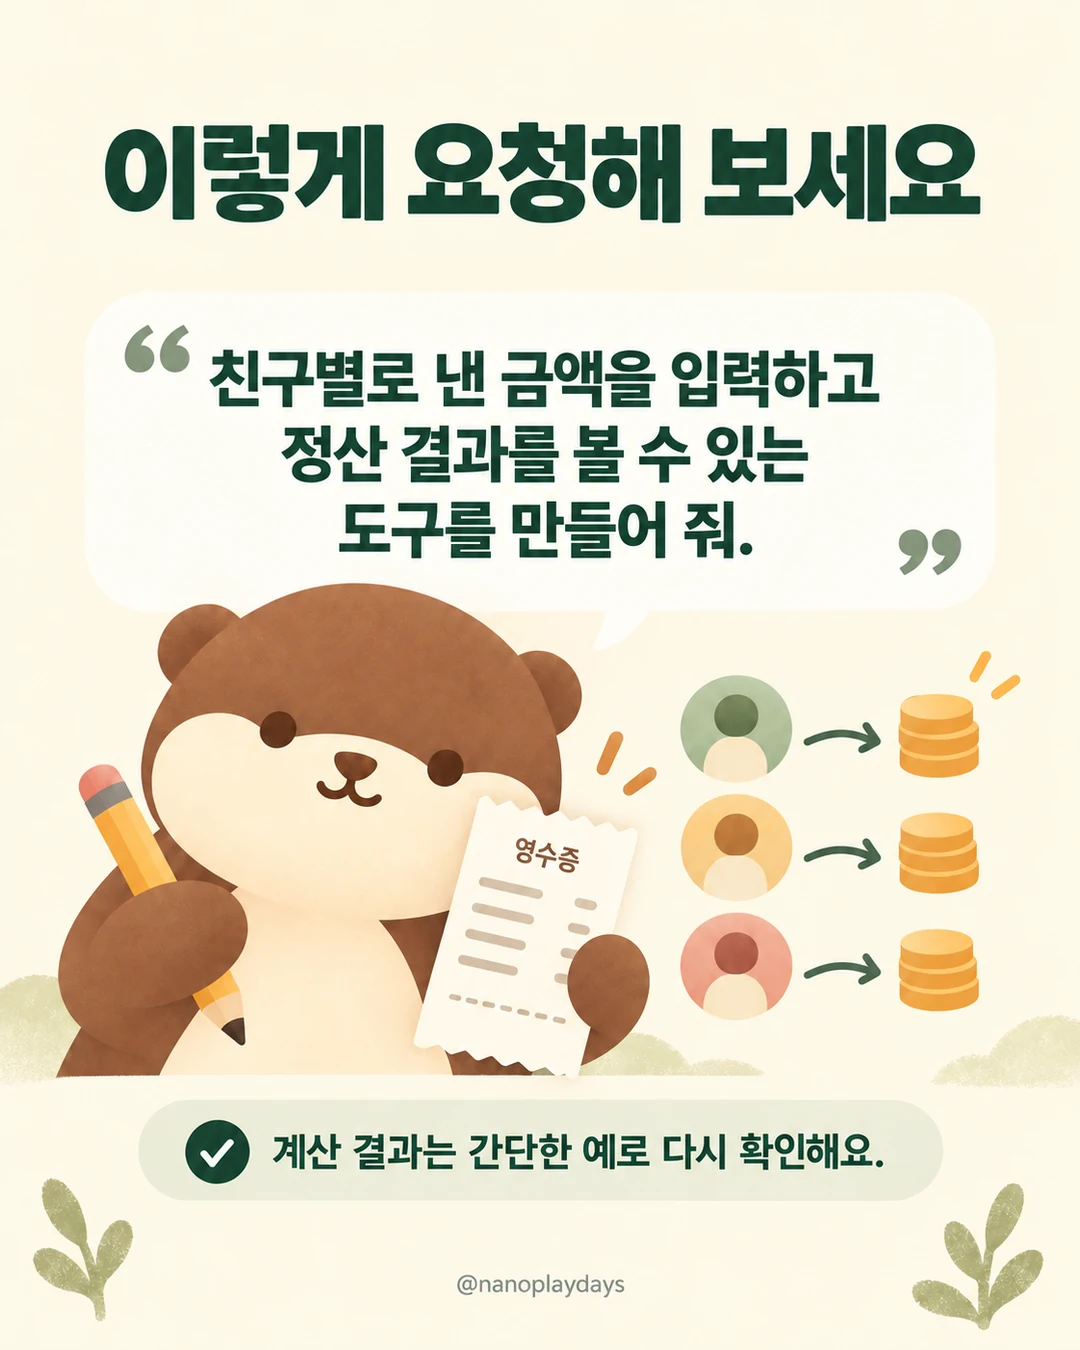
일상 작업에서는 나눠 낼 금액, 선택할 항목, 일정의 순서처럼 바꿔 볼 조건이 있는 질문을 떠올릴 수 있습니다. “친구별로 낸 금액을 입력하고 정산 결과를 볼 수 있게 해 주세요”처럼 입력과 원하는 출력을 지정하는 예시입니다. 이는 활용 제안입니다. 해당 요청을 한국어 계정에서 실행한 결과나 계산 정확도를 측정한 후기는 이번 글에 포함하지 않았습니다.
도구를 요청할 때는 필요한 입력, 계산 기준, 결과의 단위를 함께 적으면 비교가 쉬워집니다. 같은 조건을 일반 글 답변과 대화형 답변에 각각 요청해 정보가 빠졌는지 살펴볼 수도 있습니다. 화면의 완성도와 설명의 정확도를 따로 평가하면 보기 좋은 답변에서 놓친 가정을 찾는 데 도움이 됩니다.
화면은 왜 답변이 끝나기 전에 나타납니까?
OpenAI는 컴포넌트 라이브러리와 컴파일러를 사용한다고 설명합니다. 컴포넌트는 버튼·차트처럼 화면을 이루는 부품이고, 컴파일러는 모델이 생성하는 내용을 화면으로 처리하는 장치입니다. 생성 중에도 일부 화면을 점진적으로 표시하도록 설계했습니다. (구현 설명)
화면이 완성되기 전에도 일부 정보를 먼저 볼 수 있습니다. 실제 작업에서는 첫 화면을 얼마나 빨리 보여 주는지뿐 아니라, 최종 내용이 앞부분과 일관되는지와 입력을 바꾼 뒤 결과를 이해하기 쉬운지를 살피면 됩니다.
제공·이용 조건: 한국 계정은 언제 확인할 수 있습니까?
Plus·Pro·Business·Enterprise는 10월 7일부터, Free·Go는 10월 8일부터 글로벌 순차 배포 대상으로 안내됐습니다. 유료 플랜은 GPT-6 Sol, 무료·Go는 GPT-6 Luna를 사용합니다. 시스템 카드는 이번 ChatGPT 모델을 10월 버전으로, Work·Codex에서 유지되는 모델을 9월 버전으로 구분합니다. 같은 Sol·Luna 이름을 보더라도 이용 환경과 버전이 다릅니다. (배포 발표 · 버전 구분)
확인할 곳은 ChatGPT의 Chat 탭입니다. 글로벌 발표가 한국 개별 계정의 활성화 시각까지 알려 주지는 않으므로, 한국 계정의 실제 제공 여부와 한국어 대화형 화면 품질은 미확인입니다. Enterprise 사용자는 관리자 설정에 따라 제공 여부가 달라집니다. 별도로 켜는 사용자 설정, 신청 절차, 계정별 완료 시점은 이번 발표에 명시되지 않았습니다. TechCrunch는 시각 요소가 나오는 빈도를 다른 성격 설정처럼 사용자가 조절할 수 있다고 보도했는데, 이 설정의 이름과 위치는 공식 발표 본문에 없습니다. 그림이 많아 답을 읽기 어렵다면 설정 메뉴에서 해당 항목이 생겼는지 살펴볼 수 있습니다. (제공 범위)
업무용 모델을 고르는 독자는 GPT-6.1 Sol과 GPT-6 Astra의 이용 조건을 함께 참고할 수 있습니다. 공식 제품 출시 목록도 6.1 Sol과 Astra를 별도 출시 항목으로 구분합니다. Chat의 새 화면이 필요한지, 코딩·전문 작업에 쓸 모델이 필요한지에 따라 확인할 문서가 달라집니다. (공식 출시 목록)
비용·요금은 얼마나 추가됩니까?
이번 기능은 ChatGPT 요금제에 포함되는 변경으로 안내됐으며, Intelligent UI의 별도 추가 요금은 미공개입니다. Free·Go도 확대 배포 대상입니다. 기능 전용 사용 한도, 좌석 상한, 별도 원화 가격도 미공개입니다. (요금제별 배포 안내)
이미 구독 중인 사용자는 자신의 Chat 탭에서 제공되는지 먼저 확인할 수 있습니다. 새로 구독을 검토한다면 화면의 존재만으로 판단하기보다, 자주 묻는 질문을 더 쉽게 이해하게 해 주는지 확인하는 편이 유용합니다. 이번 발표를 API 가격 변경으로 연결하는 근거는 제시되지 않았습니다.
답변 시작이 44% 빠르다는 주장은 무엇을 측정합니까?
OpenAI는 웹 검색이 필요한 질문에서 GPT-6 Instant가 GPT-5.6 Instant보다 평균 44% 빨리 답변을 시작한다고 주장합니다. 또 내부의 일상 에이전트 작업 평가에서 GPT-6 Extra High는 GPT-5.6 Medium과 같은 시간에 답변을 시작하면서 GPT-5.6 Extra High보다 높은 종합 점수를 얻었다고 설명합니다. (내부 평가 설명)
측정 대상은 답변을 시작하는 시점입니다. 전체 작업 완료 시간과 한국 계정의 차트 완성 시간은 별도 측정할 항목입니다. Extra High·Medium은 비교에 쓰인 추론 강도 이름이며, Chat 화면의 사용자 선택 설정은 별도 안내를 확인할 부분입니다. 자신의 작업을 비교한다면 첫 정보가 나타난 시간, 최종 답변 완료 시간, 결과의 정확도를 나눠 기록하는 방법이 적합합니다.
안전 개선은 어떤 범위에서 확인됐습니까?
시스템 카드는 사이버·생물·폭력 관련 고위험 오용 보호를 강화하고, 여러 차례 대화를 바꾸며 보호를 우회하는 공격에 대한 저항이 좋아졌다고 설명합니다. 여러 턴을 보는 평가는 질문 하나만 보는 검사와 달리 앞선 대화까지 활용한 공격을 시험합니다. 발표는 또 답에 필요한 정보나 도구가 없을 때 그렇다고 더 쉽게 밝히도록 했다고 설명합니다. (안전 평가 개요 · 발표)
동시에 후퇴한 평가도 공개합니다. GPT-6 Sol은 표준 자해 평가에서, Luna는 표준 자해·고어·성적 콘텐츠 평가에서 통계적으로 유의한 후퇴가 있었습니다. 청소년 평가에서는 두 모델 모두 연령 제한 콘텐츠·성적 콘텐츠·정서적 의존 항목의 후퇴를 기록했습니다. OpenAI는 위반 사례를 검토하고 추가 보호를 적용했다고 설명합니다. (시스템 카드 3.1절)
안전 평가는 가장 낮은 추론 설정, 능력 평가는 최대 추론 강도에서 수행했습니다. 오류율은 어려운 사례 중심의 시험 결과이며 일반 사용 중 발생 빈도와 구분합니다. 따라서 개선과 후퇴를 함께 읽고, 어떤 조건에서 시험했는지 확인하는 것이 이번 카드의 핵심입니다. 대화형 화면의 매끄러움과 답변의 안전성·정확성도 각각 판단할 항목입니다. (평가 조건)
반응 (2026년 10월 8일 확인 기준)
HN 토론은 10월 8일 오전 기준 174점·댓글 71개입니다. 일부 댓글은 관심 있는 주제의 대화형 설명을 즉석에서 얻는 가능성을 반겼습니다. 반면 그림·여백·카드가 지나치게 많아 간단한 답을 읽는 데 방해된다는 의견과, 필요할 때만 시각적 요소가 나오기를 바란다는 의견도 있었습니다. 발표 시연에 대한 기대·우려이며 한국어 실사용 품질을 검증한 후기로 해석하기는 어렵습니다. (HN 원문)
기존 모델도 HTML 답변이나 카드 형식의 설명을 만들 수 있었다며, 무엇이 새로워졌는지 묻는 댓글도 있습니다. Gemini나 Anthropic Claude의 아티팩트도 비슷한 대화형 결과물을 만든다는 비교, 컴파일러를 거치지 않고 HTML을 바로 흘려보내면 되지 않느냐는 질문도 나왔습니다. 반대로 시각화는 화면 틀만이 아니라 모델 학습의 문제여서 차별점이 될 수 있다는 의견도 있었습니다. r/codex의 초기 글 역시 기존 인터랙티브 답변과의 차이, 기존 도구를 더 빠르고 다듬어 제공하는 변화인지를 질문했습니다. 이 Reddit 글은 점검 당시 4표의 작은 초기 반응입니다. 한국어 사용 후기는 찾지 못했습니다. (HN 토론 · r/codex 초기 질문)
참고한 자료
- GPT-6 and Intelligent UI for everyone — 2026-10-07 발표, 2026-10-08 확인.
- GPT-6 Sol and GPT-6 Luna: October 2026 update — 10월 모델 버전, 안전 개선·후퇴와 평가 조건. 2026-10-08 확인.
- OpenAI 공식 제품 출시 목록 — 기존 6.1 Sol·Astra 발표 구분. 2026-10-08 확인.
- TechCrunch: ChatGPT is getting a lot more visual — 발표 시연 예시와 시각 요소 빈도 조절 보도. 2026-10-08 확인.
- Hacker News 출시 토론 — 2026-10-08 04:03 KST 사본과 같은 날 오전 재확인.
- r/codex 초기 토론 — 2026-10-08 점검 당시 확인된 질문.